Accueil
» Comment faire
»
Pool fin SLES saturé : étendre LVM en toute sécurité et restaurer les écritures
Pool fin SLES saturé : étendre LVM en toute sécurité et restaurer les écritures
Lorsqu'un volume à provisionnement fin d'un serveur SUSE Linux Enterprise Server signale « espace insuffisant sur le périphérique », vérifiez d'abord le pool de volumes à provisionnement fin Data%. Meta%Si la zone de données est pleine et que le groupe de volumes dispose d'étendues libres, étendez le pool de volumes à provisionnement fin avec lvextendune taille supérieure à la taille virtuelle de son volume logique. Une zone de métadonnées complètement pleine est différente : elle peut nécessiter une réparation hors ligne avant la reprise des écritures normales.
La procédure ci-dessous utilise les commandes LVM2 documentées pour Linux et le modèle de stockage décrit dans le Guide d'administration du stockage de SUSE Linux Enterprise Server 15 SP7 . La disponibilité des commandes et la configuration du service peuvent varier selon le Service Pack de SLES ou l'installation en cluster. Effectuez une sauvegarde cohérente des applications et limitez les écritures importantes avant toute modification du stockage de production.
1. Vérifiez si l'espace de données ou les métadonnées sont épuisés.
Exécutez la commande suivante sur l'hôte propriétaire du pool fin actif, en remplaçant vgdatapar le nom de votre groupe de volumes :
sudo lvs -a -o lv_name,lv_size,segtype,data_percent,metadata_percent,pool_lv vgdata
Recherchez la ligne contenant thin-poolles mesures des blocs de données alloués ; celle des métadonnées de mappage du pool. Il s'agit de limites de capacité distinctes. Si la SegTypevaleur est proche de 100 mais nettement inférieure, l'ajout d'extensions de données est la solution la plus directe. Si la valeur est égale à 100, suivez les précautions de récupération décrites dans la section 4.Data%Meta%Data%Meta%Meta%
Exemple d'affichage du terminal : le pourcentage de données du pool est presque plein, tandis que son utilisation des métadonnées est bien moindre. Les valeurs indiquées illustrent les champs à examiner et ne constituent pas un résultat de diagnostic en temps réel.
Prenons un exemple hypothétique : supposons vgdata/pool0que le pool ait une capacité de 100 Gio, dont 98,12 % sont utilisés pour les données et 40,26 % pour les métadonnées. Le pool est immédiatement menacé, même si le df -hsystème indique un espace suffisant à l’intérieur d’un volume fin monté. La taille virtuelle d’un volume fin peut dépasser la capacité physique du pool, comme l’explique la documentation d’Expert Partitioner de SUSE .
Veuillez également consulter les erreurs récentes :
Un résultat vide pour la commande grep ne signifie pas nécessairement qu'aucune écriture n'a échoué. Consultez également les journaux de l'application, notamment si une base de données ou une machine virtuelle était en cours d'écriture lorsque le pool s'est saturé.
2. Vérifier que le groupe de volume possède des limites physiques libres.
Avant de modifier la taille du pool, vérifiez si le groupe de volume peut financer l'agrandissement :
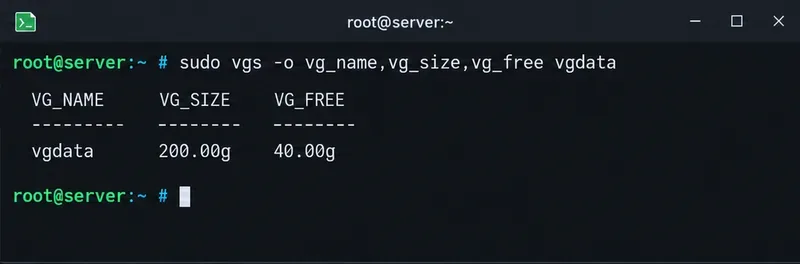
sudo vgs -o vg_name,vg_size,vg_free vgdata
Exemple de vérification de groupe de volumes : VG_FREE indique si des extensions physiques sont disponibles pour agrandir pool0 sans ajouter un autre périphérique.
Dans cet exemple hypothétique, le groupe de volumes de 200 Gio dispose de 40 Gio d'espace libre. Une extension de pool de 20 Gio est donc envisageable, sous réserve des contraintes d'allocation et de la capacité à gérer l'augmentation des métadonnées. Il est préférable de conserver une partie de l'espace du groupe de volumes plutôt que d'allouer la totalité de l'espace libre au pool.
Si VG_FREEla valeur est nulle, lvextendil est impossible d'inventer de la capacité physique. Ajoutez un volume physique correctement identifié et préparé au groupe de volumes, agrandissez le stockage sous-jacent et son volume physique LVM si nécessaire, ou récupérez des blocs avant de réessayer. La documentation SUSE explique comment ajouter des volumes physiques lors du redimensionnement d'un groupe de volumes . N'exécutez jamais cette opération pvcreatesur un disque non vérifié : cela pourrait endommager les métadonnées de stockage existantes.
3. Élargir la zone peu profonde plutôt que le volume peu important
Lorsque Data%le facteur limitant est la taille des blocs, que les métadonnées ne sont pas épuisées et que suffisamment d'espaces VG sont disponibles, étendez le pool lui-même :
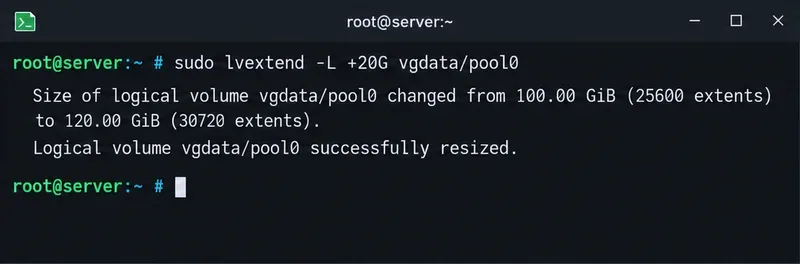
sudo lvextend -L +20G vgdata/pool0
Exemple d'extension thin-pool : la commande cible vgdata/pool0, et non le volume logique fin qu'il contient. La réponse affichée est à titre indicatif.
Cette +20Gsyntaxe ajoute 20 Gio à la taille actuelle du pool ; elle ne fixe pas la taille finale à 20 Gio. Dans cet exemple, le pool sous-jacent passe de 100 Gio à 120 Gio. Avec des données allouées inchangées, 98,12 Gio utilisés représentent environ 81,8 % du pool agrandi. Le pourcentage réel peut varier si des écritures se poursuivent pendant l’opération.
Ne pas substituer lvextend -L +20G vgdata/thin1. L'augmentation de l'espace d'adressage virtuel d'un volume fin n'augmente pas nécessairement la capacité de données physique de son pool. Cette commande étendant le pool sous-jacent plutôt que le périphérique de bloc virtuel du système de fichiers, un redimensionnement du système de fichiers n'est généralement pas nécessaire pour cette opération. Le manuel de référence sur le provisionnement fin LVM décrit le mécanisme d'extension du pool fin et ses limitations.
Lorsque vous ne pouvez pas agrandir la piscine immédiatement
Si des fichiers ont déjà été supprimés d'un système de fichiers léger et que la suppression est prise en charge par l'ensemble de la pile, envisagez de récupérer les blocs supprimés :
sudo fstrim -v /srv/data
Utilisez le point de montage réel d'un volume fin, et non le périphérique du pool fin. Une commande TRIM réussie peut réduire la Data%capacité du pool, mais la suppression de fichiers seule ne libère généralement pas de blocs. Les snapshots fins peuvent conserver les blocs partagés ; un pool configuré pour ignorer les blocs supprimés n'en tirera aucun avantage. Ne considérez pas TRIM comme une solution de secours fiable pour remplacer la capacité physique, surtout si les écritures échouent. Supprimez les anciens snapshots uniquement après avoir vérifié leur propriétaire, leurs dépendances et leurs exigences de conservation ; la suppression d'un snapshot est irréversible.
4. Considérer une zone de métadonnées complète comme une condition de récupération
Si Meta%la saturation atteint 100 %, interrompez les écritures applicatives et planifiez une interruption contrôlée. LVM avertit que l'épuisement des métadonnées peut rendre incohérents les métadonnées et les systèmes de fichiers du pool fin. Augmenter la taille des données du pool, relancer les écritures ou forcer l'activation ne résout pas ce risque.
La procédure de récupération documentée consiste à désactiver hors ligne le pool concerné, à réparer ses métadonnées incomplètes à l'aide de l'outil approprié lvconvert --repair VG/ThinPool, à augmenter sa capacité de métadonnées à l'aide de lvextend --poolmetadatasizel'outil approprié, puis à vérifier chaque système de fichiers affecté avec l'outil hors ligne adéquat. Par exemple, un pool dont le volume logique de métadonnées est inférieur à 2 Gio peut nécessiter une cible vérifiée telle que :
sudo lvextend --poolmetadatasize 2G vgdata/pool0
Il est fortement déconseillé d'exécuter cette commande sans précaution sur un pool actif endommagé. La taille indiquée est un exemple et non une exigence universelle. Vérifiez au préalable la taille actuelle des métadonnées, les extents disponibles, la désactivation correcte, le support de récupération et les sauvegardes. Cette opération lvconvert --repairdoit être planifiée avec une expertise en matière d'indisponibilité et de récupération ; le manuel LVM précise qu'une panne est possible et que les données peuvent être irrécupérables. Conservez l'ancien volume logique de métadonnées jusqu'à ce que le pool et les systèmes de fichiers aient été vérifiés. Une sauvegarde de la configuration LVM vgcfgbackupne sauvegarde pas les métadonnées des pools fins. Pour les données critiques, contactez le support SUSE ou votre équipe de récupération de stockage avant toute tentative de réparation.
5. Activez l'extension automatique, puis vérifiez les écritures.
Une fois le système stabilisé, configurez une politique de croissance proactive dans la activationsection correspondante /etc/lvm/lvm.conf. Cet exemple démarre l'extension à 70 % d'utilisation et demande une croissance de 20 % ; ajustez ces valeurs en fonction du taux d'écriture et de la capacité VG disponible.
Assurez-vous que les paramètres sont appliqués à la portée de configuration appropriée et que le pool est surveillé :
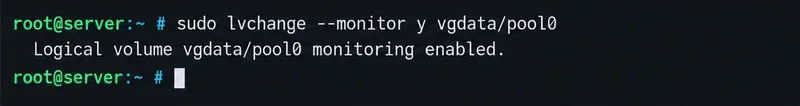
sudo lvchange --monitor y vgdata/pool0
Exemple de commande de surveillance : l’activation de la surveillance des événements LVM permet aux politiques de croissance automatique du pool d’agir lorsqu’il reste suffisamment d’étendues libres.
L'extension automatique du pool fin dépend de la surveillance des événements LVM dmeventdet de la disponibilité d'étendues libres suffisantes. Vérifiez le service de surveillance fourni par votre installation SLES (par exemple, systemctl status lvm2-monitorl'unité correspondante) et consultez ses journaux. Un seuil ne garantit pas la protection si les écritures dépassent la capacité de l'extension ou si le groupe de volumes est déjà plein. Consultez le manuel LVM pour en savoir plus sur l'extension automatique et les options de surveillance lvchange .
Vérifiez que la correction a fonctionné
Veuillez relire à la fois le taux d'utilisation du pool et la capacité restante du VG :
Data%Après l'extension du pool de données, la quantité de données devrait avoir diminué, Meta%le pool doit rester en dessous de son niveau maximal et le pool doit être actif sans nouvelles erreurs d'E/S. Vérifiez l'état du système de fichiers et les journaux d'application, puis effectuez un test d'écriture et de lecture simple et adapté à l'application avant de libérer les charges de travail suspendues. Si des erreurs persistent après la disponibilité d'espace, maintenez la charge de travail concernée hors ligne jusqu'à ce que l'intégrité de son système de fichiers et de son application ait été évaluée ; l'ajout de capacité ne peut pas annuler les écritures ayant déjà échoué ou perdues.