Accueil
» Comment faire
»
Diagnostic d'un serveur SUSE bloqué sur l'écran d'arrêt de systemd
Diagnostic d'un serveur SUSE bloqué sur l'écran d'arrêt de systemd
Si SUSE Linux Enterprise Server se bloque lors de l'arrêt par systemd, identifiez l'unité concernée par une tâche d'arrêt en cours ou examinez les derniers messages du démarrage précédent, puis corrigez cette unité ou sa dépendance. Une unité est une ressource gérée par systemd, comme un service ou un point de montage ; une tâche d'arrêt est une demande d'arrêt envoyée par systemd à une unité. N'essayez pas de réduire le délai d'expiration global ni de forcer l'arrêt en premier lieu, car un service ou un système de fichiers peut encore être en train de fermer des fichiers ou d'écrire des données.
Cette procédure pas à pas suit la documentation SLES 15 SP7 vérifiée en octobre 2026. La politique d'arrêt exacte dépend du fournisseur de services et de stockage ; suivez donc leurs instructions pour toute modification spécifique à l'unité.
1. Observez l'arrêt en toute sécurité
Étape 1 : Enregistrez le message exact et attendez des preuves utiles.
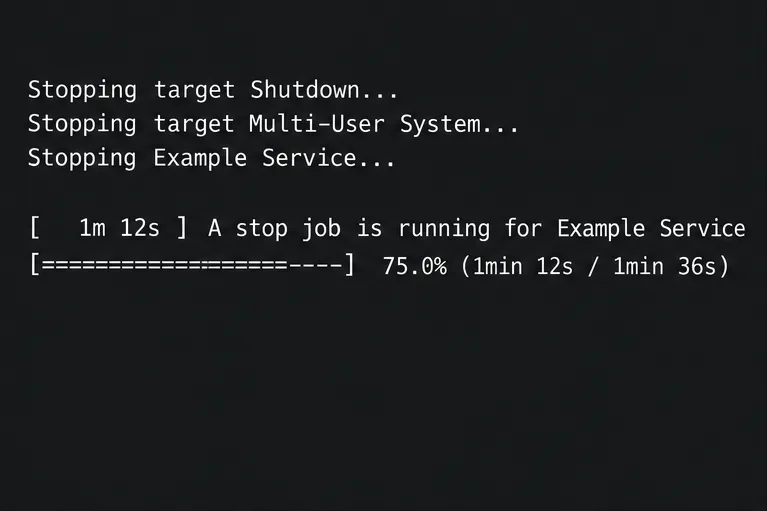
Si la console affiche « Une tâche d'arrêt est en cours… » avec un compte à rebours, notez le service ou le montage concerné et vérifiez si le compte à rebours change. Cela signifie que systemd attend la fin de l'opération d'arrêt, et non que le système d'exploitation a nécessairement planté ; les bases de données et le stockage distant peuvent avoir besoin de temps pour se fermer correctement.
Un exemple de message de console indique l'unité que systemd attend ; le service affiché et le compte à rebours sont donnés à titre d'illustration.
Observez via une console distante ou série, ou tout autre terminal disponible. Évitez les commandes de réinitialisation ou d'alimentation pendant les opérations d'écriture. Si le système cesse de répondre, notez la dernière ligne affichée et poursuivez la procédure après le redémarrage.
2. Trouvez l'unité qui attend.
Étape 2 : Vérifier si la machine accepte toujours les commandes des tâches systemd
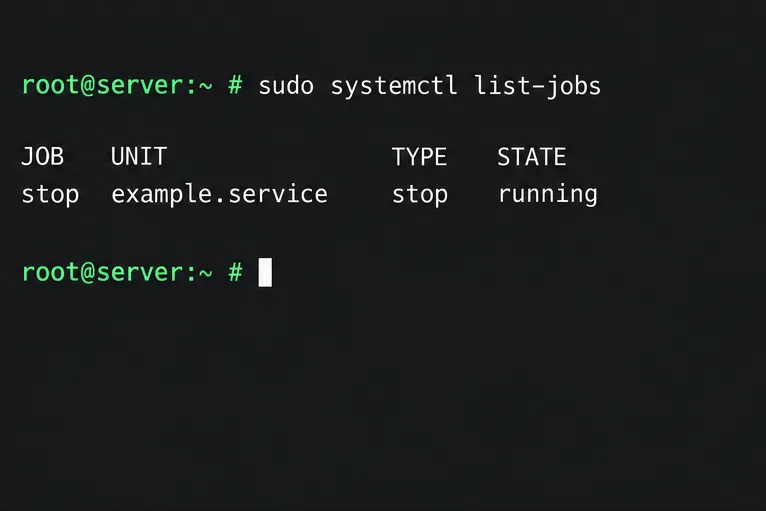
Si SSH ou un deuxième terminal fonctionne encore, demandez à systemd quels travaux sont en cours d'exécution ou en attente, puis vérifiez l'unité nommée à l'écran :
sudo systemctl list-jobs
sudo systemctl status SERVICE.service
La liste des tâches peut identifier un service dont l'opération d'arrêt est toujours en cours ; la ligne affichée en est un exemple.
Remplacez SERVICEpar le nom réel de l'unité. Une tâche d'arrêt en cours affine la recherche, mais n'explique pas pourquoi le processus ne s'est pas terminé. Consultez son état et ses journaux avant de modifier la configuration. Si systemd ne répond plus, n'annulez pas les tâches sans consulter le journal précédent une fois l'hôte rétabli.
3. Utilisez le démarrage précédent pour identifier la cause
Étape 3 : Lire la fin du journal de démarrage précédent
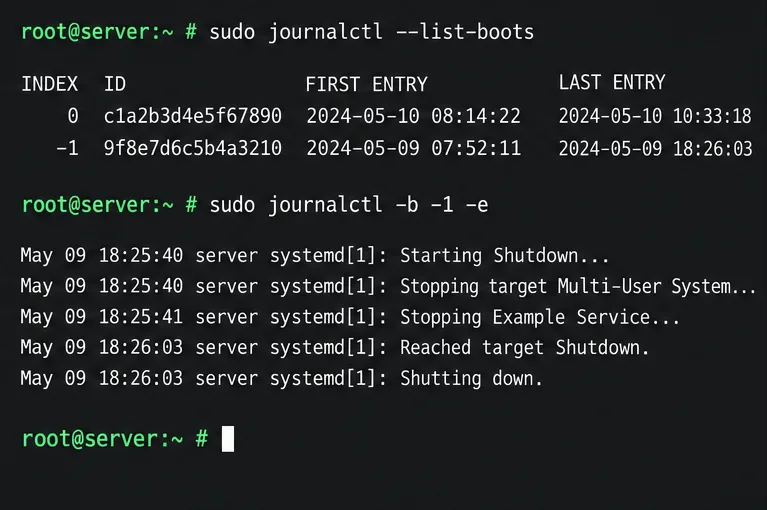
Le journal est le journal indexé de systemd contenant les messages du noyau, des services et du système. Après le prochain démarrage réussi, listez les démarrages enregistrés et examinez la fin du précédent :
Le -1décalage sélectionne le démarrage précédent et -ese déplace vers ses entrées les plus récentes.
Recherchez le dernier message « Arrêt en cours », un délai d'attente dépassé, des tentatives de redémarrage, ou un périphérique ou un point de montage nommé. La dernière ligne n'est qu'un indice : l'ordre d'arrêt peut laisser une autre unité en attente. Comparez les horodatages et les messages voisins.
Étape 4 : Filtrer les journaux pour le service suspecté
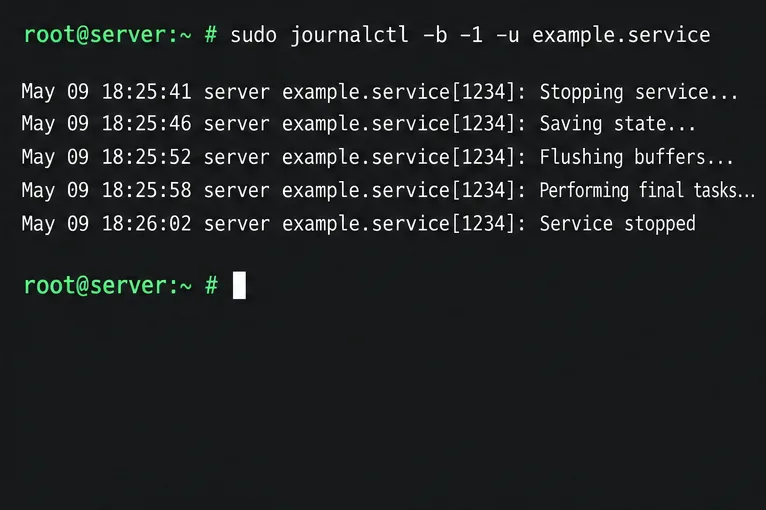
Lorsque l'écran ou le journal mentionne un service, interrogez uniquement les entrées de démarrage précédentes de cette unité. Examinez également sa configuration chargée :
Le filtrage par unité permet de distinguer un arrêt de service lent des messages sans rapport ailleurs dans le journal.
Vérifiez la présence d'un ExecStopscript personnalisé en attente indéfinie, d'un processus enfant persistant ou d'une erreur d'application dans son gestionnaire d'arrêt. Pour les équipements propriétaires, comparez le package et la configuration avec les instructions fournies avant toute modification.
Étape 5 : Ne vérifiez les supports et le stockage que lorsque les preuves le démontrent.
Si le journal mentionne un point de montage, un périphérique ou un système de fichiers distant, examinez la table des points de montage et l'entrée correspondante dans/etc/fstab :
sudo findmnt --verify --verbose
Utilisez la vérification de montage lorsque les journaux font état d'un montage ; les entrées affichées sont données à titre indicatif et doivent être vérifiées par rapport à l'hôte.
Vérifiez si une dépendance distante NFS, CIFS, iSCSI ou autre est accessible et attendue lors de l'arrêt. Supprimez une entrée de montage obsolète uniquement après avoir confirmé qu'elle est inutilisée. Ne forcez pas le démontage d'un système de fichiers actif suite à un redémarrage lent.
4. Corrigez la cause sans la dissimuler.
Étape 6 : Réparer le service ou ajuster uniquement sa politique d’arrêt documentée
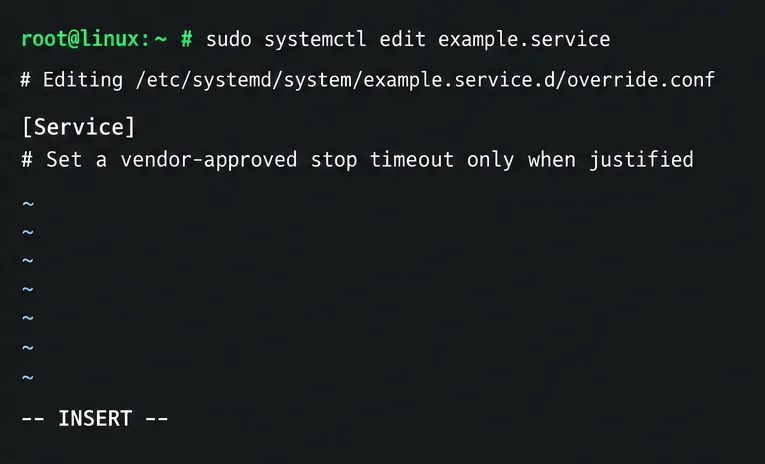
Pour un service qui ne s'arrête pas, commencez par corriger son script d'arrêt, la configuration de l'application ou un problème de paquet. Un fichier de configuration par unité sudo systemctl edit SERVICE.serviceest disponible /etc/systemd/system/sans modification du fichier fournisseur. Consultez la documentation SUSE TimeoutSecpour le démarrage et l'arrêt du service ; utilisez une valeur approuvée par le fournisseur pour cette charge de travail.
Un module complémentaire peut contenir une valeur de remplacement ciblée ; la note affichée est une indication, et non une valeur de délai d'expiration.
Après une modification documentée, rechargez les définitions d'unités systemd sudo systemctl daemon-reloadet examinez le résultat sudo systemctl cat SERVICE.service. Un délai d'attente plus long peut permettre à un arrêt légitime de se terminer, mais peut également prolonger un redémarrage ayant échoué. Un délai plus court peut interrompre un service avant qu'il n'ait vidé son état. Ne modifiez pas les valeurs par défaut globales pour masquer le défaut d'une unité.
Étape 7 : Conserver les journaux pour le prochain incident
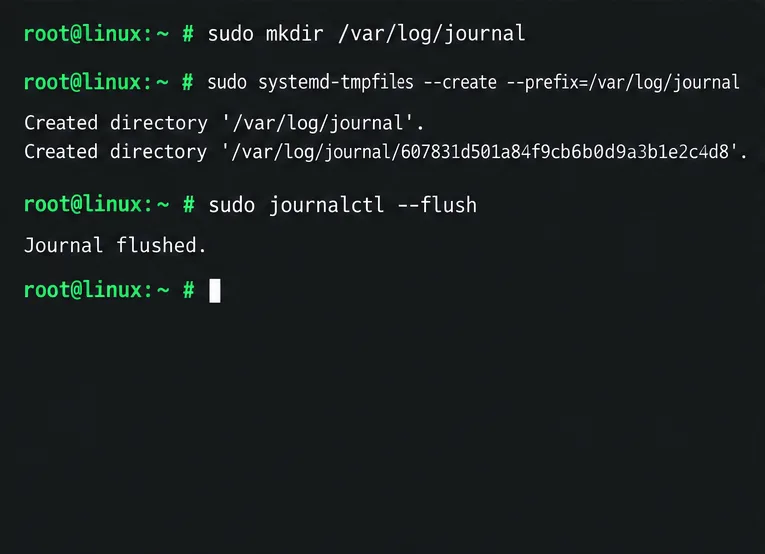
Par défaut, SLES stocke les données du journal dans /run/log/journal/un répertoire temporaire, qui est effacé au redémarrage. S'il journalctl -b -1ne contient aucune entrée de démarrage précédent, activez le stockage persistant du journal pour les diagnostics ultérieurs :
Ces commandes préservent les nouvelles entrées du journal lors des redémarrages ; elles ne peuvent pas restaurer les journaux déjà perdus sur un support de stockage volatile.
Les journaux persistants utilisent de l'espace sous/var ; SUSE indique que le journal peut utiliser jusqu'à 10 % de cet espace système par défaut. Vérifiez l'espace libre et la durée de rétention, en particulier sur les petits /varvolumes.
5. Vérifiez le prochain redémarrage prévu
Étape 8 : Vérifiez que l’arrêt est terminé et que le serveur est de nouveau en service.
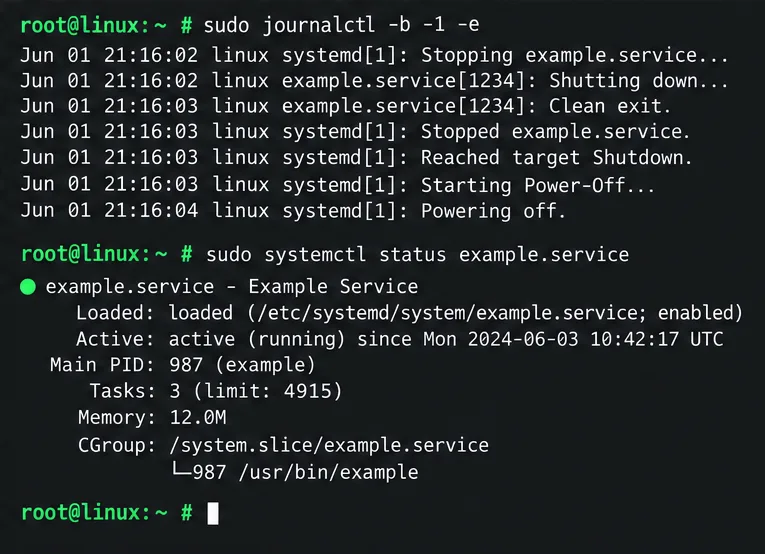
Une fois la cause suspectée corrigée, planifiez un redémarrage contrôlé avec accès à la console. Après le redémarrage de la machine, examinez les derniers messages du démarrage précédent et vérifiez l'état actuel du service.
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service
Après un redémarrage ultérieur, vérifiez que l'arrêt précédent a atteint ses derniers messages et que le service est de nouveau opérationnel ; ceci est un exemple, et non une preuve de test.
Le problème est résolu lorsque le serveur s'arrête sans attendre sur la même unité, redémarre normalement et que le service ou le montage fonctionne. Si les journaux s'interrompent brutalement ou affichent des erreurs de noyau, de contrôleur ou de matériel, conservez-les et contactez SUSE ou le fournisseur du matériel pour obtenir de l'aide, plutôt que de modifier les délais d'attente.
Pour plus de détails sur les commandes, consultez le guide systemd de SLES 15 SP7 et le guide SUSE sur les journaux persistants et les filtres journalctl . Ces étapes permettent d'identifier les causes probables des blocages ; la solution appropriée (service, système de fichiers ou matériel) dépend de l'unité désignée par les journaux de la machine.