Accueil
» Comment faire
»
Créez d'abord un cluster SLES 15 HA pris en charge avec le fencing.
Créez d'abord un cluster SLES 15 HA pris en charge avec le fencing.
Pour SLES 15, enregistrez l'extension SUSE Linux Enterprise High Availability, puis utilisez-la crm cluster initpour crm cluster joininitialiser les nœuds. Avant de déployer des services sur le cluster, vérifiez la redondance du réseau, l'isolation des nœuds (STONITH) et le quorum.
Cette procédure suit la documentation SLE HA 15 SP7 en vigueur en octobre 2026. Vérifiez votre Service Pack installé et l'architecture de votre processeur ; les identifiants d'enregistrement et les détails de support peuvent varier.
1. Préparer les nœuds et le réseau
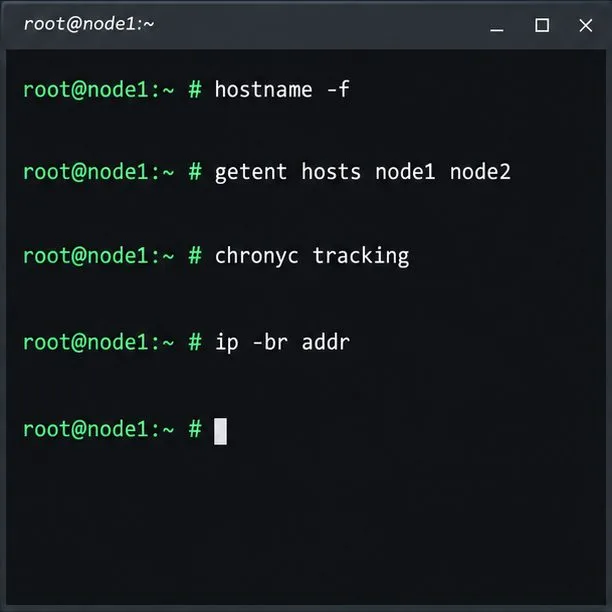
Vérifiez la dénomination des hôtes, la résolution des noms, la synchronisation de l'heure et l'état des interfaces sur chaque nœud avant de former le cluster.
Utilisez au moins deux nœuds sur la même architecture de processeur prise en charge, des adresses IP principales statiques, des noms uniques résolvables sur chaque nœud et des horloges synchronisées à l'aide d'une source de temps externe. SUSE exige deux chemins de communication TCP/IP redondants par nœud ; les noms d'interface doivent correspondre sur tous les nœuds.
Effectuez les vérifications sur les deux nœuds et confirmez que les interfaces et les noms sélectionnés sont corrects avant l'amorçage.
2. Enregistrez et installez l'extension de haute disponibilité
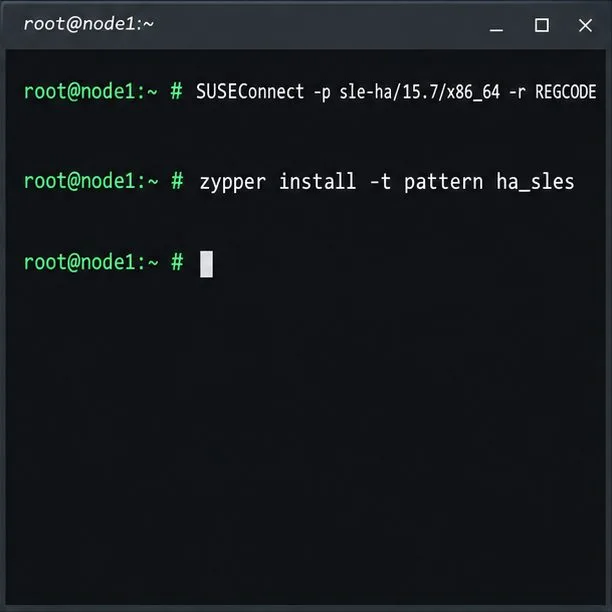
Sur chaque nœud, enregistrez l'extension SLE HA et installez son modèle de gestion de cluster.
SLE HA est une extension enregistrée séparément ; SLES seul n’inclut pas le modèle de cluster. Pour les nœuds SLES 15 SP7 x86_64 enregistrés, activez l’extension et installez le modèle sur chaque nœud :
Remplacez ADDITIONAL_REGCODEpar votre code d'abonnement. L'identifiant du produit est destiné à l'architecture x86_64 ; utilisez l'identifiant SUSE correspondant pour les autres architectures. Assurez-vous que tous les nœuds utilisent le même niveau de service SLES et de haute disponibilité SLE. Consultez le guide d'installation de SLE HA 15 SP7 de SUSE .
3. Déterminer les modalités de clôture et le quorum avant l'initialisation.
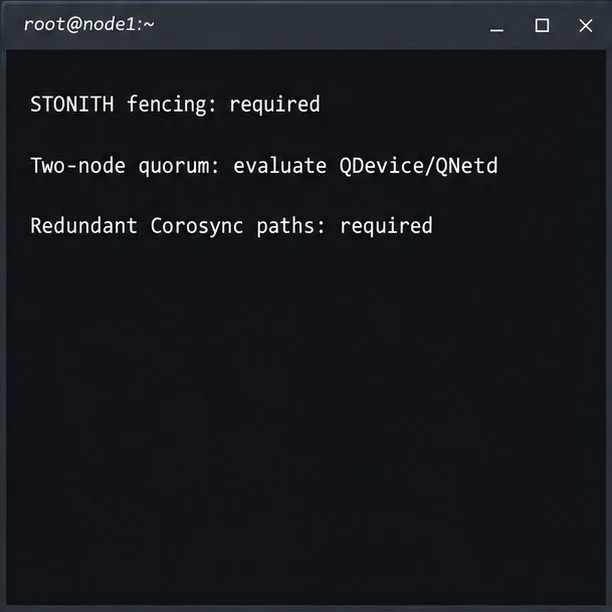
Le fenêtrage est une exigence de support ; un cluster à deux nœuds doit également être conçu en tenant compte du comportement de quorum.
Pour les clusters compatibles, le fencing de nœuds (STONITH) doit stonith-enabledêtre startup-fencingactivé. Le fencing isole un nœud incertain afin d'empêcher l'exécution du même service sur les deux côtés d'une partition. Choisissez un dispositif de contrôle d'alimentation ou un SBD compatible avec un système de surveillance testé pour votre matériel ou hyperviseur.
Pour deux nœuds : SUSE recommande QDevice/QNetd pour les clusters à nombre pair de nœuds. Ce système ajoute un vote de quorum indépendant, et non une isolation ; configurez d’abord le serveur QNetd séparé si vous incluez QDevice lors de l’amorçage. Consultez le guide QDevice et QNetd .
Idée fausse concernant le stockage : le stockage partagé n’est pas obligatoire pour tous les clusters, mais les données applicatives nécessitent une architecture dédiée, partagée, répliquée ou récupérable. Pacemaker déplace les ressources ; il ne copie pas les données applicatives.
4. Initialiser le premier nœud
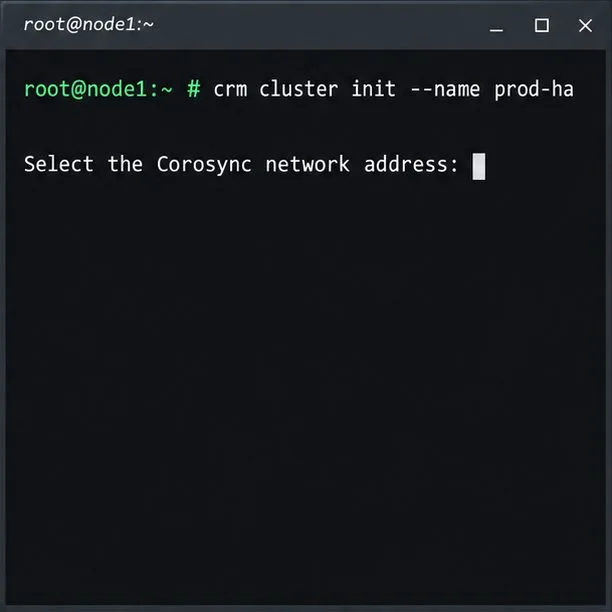
Le script d'amorçage démarre sur le nœud 1 et demande l'adresse réseau que Corosync doit utiliser.
Sur le nœud 1, démarrez le processus d'amorçage CRM Shell en tant que root ou via votre configuration d'utilisateur sudo approuvée :
crm cluster init --name prod-ha
Suivez les instructions et sélectionnez l'adresse Corosync souhaitée. Le script configure Corosync, SSH, Csync2, les ports du pare-feu du cluster et Hawk2 ; il vérifie la synchronisation de l'heure et propose en option SBD ainsi qu'une adresse IP d'administration pour Hawk2. Consultez /var/log/crmsh/crmsh.logles paramètres d'amorçage.
Configurez le watchdog sur chaque nœud avant de sélectionner SBD. Si vous utilisez une protection externe, configurez la ressource STONITH correspondante avant les charges de travail. Ne désactivez jamais STONITH pour contourner un périphérique manquant. Bootstrap crée un cluster de base, et non une application haute disponibilité.
5. Rejoignez le deuxième nœud
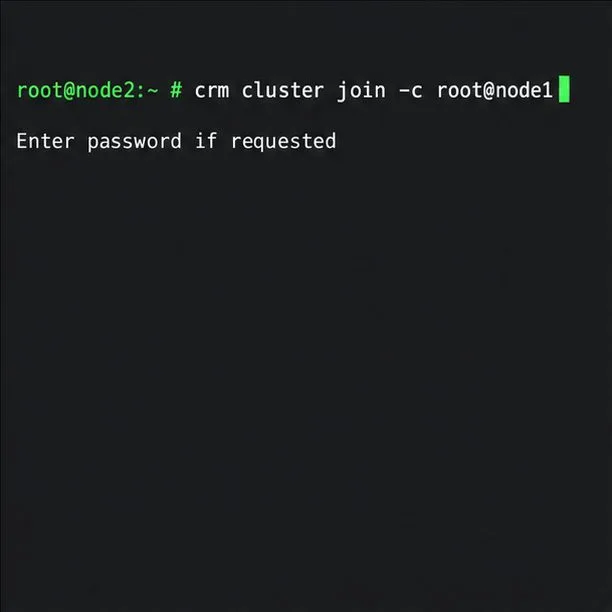
Exécutez la commande join sur le nœud 2 ; utilisez les mêmes choix d’interface réseau que lors de l’initialisation.
Installez et enregistrez SLE HA sur le nœud 2. Si vous utilisez SBD, configurez son watchdog avant de rejoindre le nœud. Ensuite, en tant que root :
crm cluster join -c root@node1
Pour une configuration avec privilèges sudo, suivez la procédure SUSE USER@NODE1. Spécifiez les deux mêmes interfaces si elles sont configurées lors de l'initialisation. Le script copie les paramètres Corosync, configure SSH et Csync2, et met le nœud 2 en ligne. Répétez l'opération pour les autres nœuds ; n'utilisez pas simultanément les méthodes d'installation bootstrap et YaST.
6. Confirmer l'adhésion et sécuriser l'administration
Vérifiez l'adhésion auprès du CRM et remplacez le mot de passe d'amorçage du cluster HA avant d'utiliser Hawk2.
Depuis un nœud du cluster, vérifiez l'appartenance :
crm status
Vérifiez que les deux nœuds sont en ligne et que le quorum est atteint. Le processus d'amorçage utilise haclusterun mot de passe initiallinux ; modifiez-le sur chaque nœud initialisé.
passwd hacluster
Hawk2 utilise le protocole HTTPS sur le port 76308080. Vérifiez le certificat auto-signé auprès de votre administrateur avant de lui faire confiance. L'adresse IP de gestion de Hawk2 n'est pas l'adresse client de l'application.
7. Ajoutez des ressources pour le service que vous devez réellement protéger
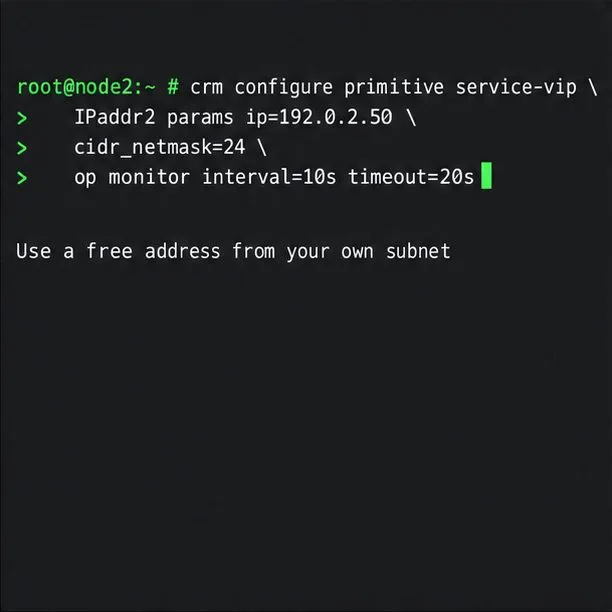
L'exemple définit uniquement une ressource IP flottante ; remplacez son adresse de documentation par une adresse inutilisée de votre sous-réseau.
Pacemaker gère les services via des agents de ressources. Installez et configurez la charge de travail sur les nœuds éligibles. Cet exemple crée uniquement une adresse IP flottante.
192.0.2.50Cette adresse est réservée à la documentation. Remplacez-la par une adresse libre et le préfixe correct de votre sous-réseau. Une adresse IP primitive ne lance pas d'application et ne réplique pas les données. Ajoutez l'agent compatible de l'application, ainsi que les paramètres d'ordonnancement, de colocation et de stockage spécifiques à la charge de travail ; suivez les instructions de récupération et de protection du produit.
8. Tester le basculement avant de déclarer le cluster prêt.
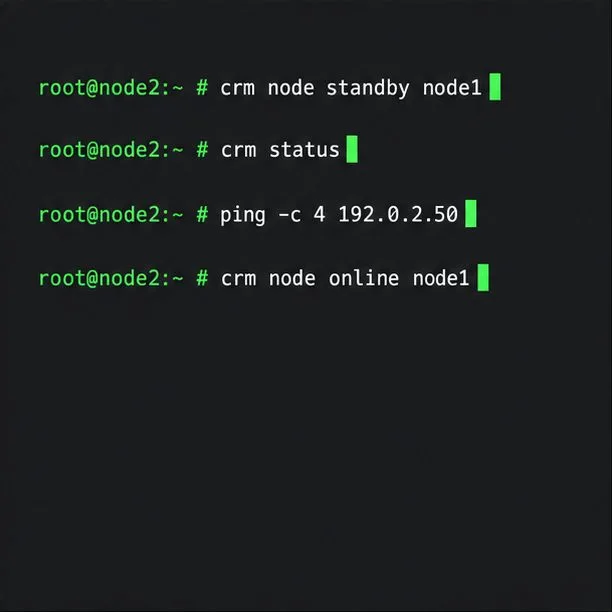
Un test de veille planifié vérifie que la ressource se déplace, puis remet le nœud en service.
Après avoir configuré les ressources réelles et le périmètre de sécurité, planifiez un test de basculement contrôlé. Mettez le nœud 1 en veille et vérifiez le service depuis le nœud 2 :
Remplacez SERVICE_VIPpar l'adresse réelle du client. Vérifiez que l'application répond, que les ressources sont déplacées comme prévu et que le nœud 1 rejoint le réseau. La commande ping vérifie uniquement l'accessibilité du réseau. SUSE crm cluster crash_testperturbe intentionnellement certains composants ; utilisez-la donc dans un environnement de test planifié. Consultez le guide de démarrage rapide et le guide de configuration de SLE HA .
Vérifier la disponibilité du service
Après les tests, vérifiez que les deux nœuds présentent l'état attendu, que le fencing reste activé et que la charge de travail répond via son point de terminaison client une fois le nœud 1 de nouveau en ligne. Un affichage d'appartenance au vert ou un ping réussi ne suffisent pas à prouver la récupération de l'application.