Accueil
» Technologie
»
Semiconducteurs de nouvelle génération : comment l’IA et le supercalcul s’affranchissent des transistors plus petits
Semiconducteurs de nouvelle génération : comment l’IA et le supercalcul s’affranchissent des transistors plus petits
En bref : les progrès de l’IA proviennent désormais de l’ensemble du système des semi-conducteurs.
La prochaine génération de matériel d'IA et de supercalculateurs ne repose pas sur une seule avancée majeure. Elle est construite à partir de plusieurs technologies qui doivent fonctionner de concert : transistors à grille enveloppante, alimentation par l'arrière, architectures à puces, encapsulation avancée, mémoire à large bande passante, liaisons inter-puces plus rapides et réseaux optiques de plus en plus performants. Concrètement, cela se traduit par une puissance de calcul accrue, une bande passante mémoire plus importante et une meilleure mise à l'échelle, sans dépendre uniquement de la miniaturisation des transistors.
C'est important car les accélérateurs d'IA et les supercalculateurs scientifiques modernes atteignent souvent leurs limites de transfert de données et de consommation d'énergie avant même d'épuiser leur capacité de calcul brute. Un moteur matriciel plus rapide n'est utile que si les poids du modèle, les activations et les résultats intermédiaires peuvent lui parvenir suffisamment vite. De même, l'ajout d'accélérateurs supplémentaires n'est pertinent que si l'infrastructure (architecture, réseau de racks, système de mémoire, système de refroidissement et pile logicielle) peut assurer leur fonctionnement optimal.
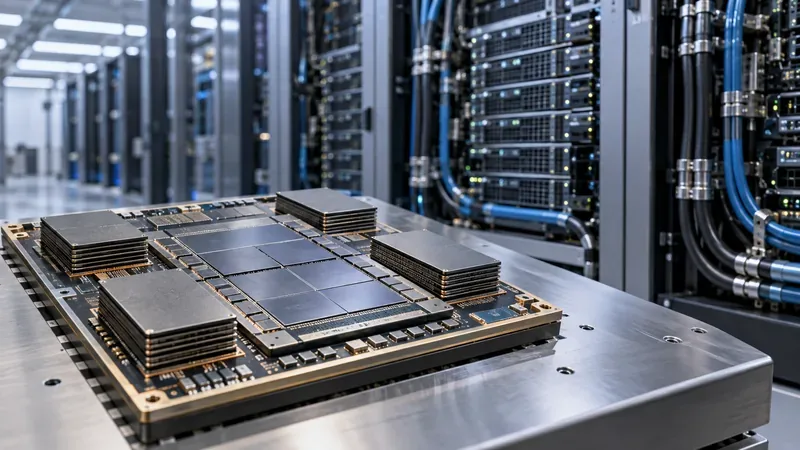
Un module d'accélération multi-puces avec plusieurs modules de mémoire empilés illustre l'orientation du matériel d'IA moderne : le calcul, la mémoire, le conditionnement, l'alimentation électrique et le refroidissement sont de plus en plus conçus comme un seul système.
1. Les nouvelles structures de transistors améliorent l'efficacité, mais ce n'est qu'un point de départ.
Les technologies logiques de pointe s'affranchissent de la structure FinFET qui a dominé les puces avancées pendant des années. Les architectures à grille enveloppante (GAA) consistent à enrouler la grille autour d'une nanofeuille ou d'une structure de canal similaire, offrant ainsi aux concepteurs de puces un contrôle électrostatique plus précis à mesure que la taille des composants diminue. Ceci permet d'améliorer les performances, de réduire les courants de fuite ou d'obtenir un meilleur compromis entre les deux.
TSMC annonce que son procédé N2 de 2 nanomètres est entré en production de masse au quatrième trimestre 2025, tandis que sa technologie A16 combine des transistors en feuillets nanométriques avec une alimentation arrière, conçue spécifiquement pour les produits informatiques hautes performances nécessitant une alimentation électrique dense. TSMC prévoit une production de masse de la technologie A16 pour le second semestre 2026. Consultez la page dédiée à la technologie A16 et le rapport annuel 2025 du fondeur .
Intel explore une voie similaire avec le procédé Intel 18A. Ce procédé combine des transistors RibbonFET GAA avec une alimentation PowerVia côté arrière. Intel annonce que la production du 18A a débuté en 2025, tandis que la version améliorée 18A-P est entrée en production à risque en juin 2026. Intel publie également des données comparatives sur les performances, la consommation et la densité de ce procédé ; ces chiffres sont fournis par le fabricant et doivent être validés par rapport à une conception spécifique, et non considérés comme des gains universels au niveau de la puce. Les détails les plus récents sont disponibles sur la page dédiée au procédé Intel 18A .
L'alimentation côté face arrière est cruciale, car les puces avancées doivent acheminer signaux et alimentation via un câblage extrêmement dense. Déplacer une partie du réseau d'alimentation vers la face arrière permet de libérer des ressources de routage côté signal et d'améliorer la distribution de tension. Pour les accélérateurs d'IA, où de grands ensembles d'unités de calcul commutent à haute fréquence, cela peut s'avérer aussi important que la densité de transistors.
2. Les puces et l'encapsulation avancée transforment un emballage en un petit système informatique.
Les puces monolithiques deviennent plus difficiles et plus coûteuses à industrialiser à mesure que leur taille augmente. Les chiplets offrent une alternative : des fonctions distinctes peuvent être fabriquées selon des procédés de fabrication adaptés, puis intégrées dans un seul boîtier. Une puce de calcul peut nécessiter un procédé logique très avancé, tandis que les E/S, le cache, les circuits analogiques ou d’autres fonctions peuvent ne pas en nécessiter.
C'est le conditionnement qui rend cette technologie pratique. La plateforme de conditionnement avancée CoWoS de TSMC , par exemple, est conçue pour intégrer plusieurs dispositifs logiques et des piles de mémoire à large bande passante dans un boîtier 2.5D. TSMC positionne spécifiquement CoWoS pour les produits d'IA et de HPC, où des connexions courtes et larges entre le calcul et la mémoire HBM sont essentielles.
Des normes émergent également pour rendre les chiplets moins propriétaires. La spécification UCIe 3.0 , publiée en août 2025, prend en charge les débits de données de 48 GT/s et 64 GT/s et ajoute des fonctionnalités pour une meilleure efficacité énergétique, une gestion simplifiée et des systèmes multi-puces plus flexibles. UCIe ne rend pas les chiplets interchangeables du jour au lendemain, mais elle fournit à l'industrie un cadre électrique et protocolaire commun pour les liaisons sur boîtier.
Cette approche est particulièrement intéressante lorsqu'une entreprise souhaite concevoir plusieurs variantes d'accélérateurs à partir de modules réutilisables. Elle l'est moins lorsque le coût du boîtier, la densité thermique ou la complexité de la conception l'emportent sur les avantages de la modularité. Un produit plus petit, aux besoins modestes en mémoire et en E/S, peut encore être mieux servi par un dispositif monolithique plus simple.
3. La mémoire à large bande passante devient aussi stratégique que l'accélérateur lui-même.
Les charges de travail d'IA déplacent fréquemment de grands tenseurs entre la mémoire et les unités de calcul. La bande passante mémoire constitue donc une contrainte de conception primordiale. La mémoire à large bande passante (HBM) résout ce problème en empilant des puces DRAM et en les plaçant physiquement à proximité de l'accélérateur via une interface très large.
La mémoire HBM4 passe désormais du stade de feuille de route à celui de système commercial. Samsung a annoncé les premières livraisons commerciales de HBM4 en février 2026 et a indiqué que son produit était entré en production de masse avec un débit de transfert soutenu de 11,7 Gbit/s, pouvant atteindre 13 Gbit/s. En mai 2026, Samsung a également annoncé la livraison d'échantillons de HBM4E. Ces informations sont disponibles dans l'annonce de production de la HBM4 de Samsung .
SK hynix a annoncé dans ses résultats du deuxième trimestre 2026 avoir entamé les livraisons en masse de HBM4 au cours de ce trimestre et prévoit d'augmenter sa production au second semestre. L'entreprise a également expédié des échantillons de HBM4E à 12 couches. Pour connaître la situation actuelle, veuillez consulter les résultats du deuxième trimestre 2026 de SK hynix .
Pourquoi est-ce important en pratique ? Les spécifications actuelles de la carte graphique NVIDIA Vera Rubin indiquent 288 Go de mémoire HBM4 et une bande passante mémoire GPU de 19,2 To/s. À titre de comparaison, les accélérateurs AMD de la série MI350 utilisent de la mémoire HBM3E ; AMD annonce jusqu'à 288 Go et 8 To/s pour le MI355X. Ces architectures sont différentes et ne doivent pas être comparées uniquement sur la base d'une seule valeur de bande passante. Toutefois, ces deux exemples illustrent comment la capacité et la bande passante de la mémoire sont désormais des spécifications essentielles des accélérateurs, et non plus des détails secondaires. Consultez les spécifications officielles de la NVIDIA Vera Rubin NVL72 et la page dédiée à la série AMD Instinct MI350 .
4. Les interconnexions de montée en charge et d'extension horizontale déterminent si plusieurs accélérateurs fonctionnent comme un seul.
Les modèles complexes et les simulations scientifiques tiennent rarement parfaitement sur un seul dispositif. Le système doit répartir la charge de travail entre plusieurs accélérateurs et échanger fréquemment des résultats partiels. Si la communication est lente, des unités de calcul coûteuses restent inactives.
C’est pourquoi les architectures d’interconnexion propriétaires évoluent de pair avec les GPU. La plateforme Rubin de NVIDIA utilise NVLink de sixième génération ; NVIDIA annonce une bande passante NVLink de 3 To/s par GPU Rubin et de 216 To/s pour un système NVLink 72. AMD utilise Infinity Fabric sur ses plateformes d’accélération. Pour les acheteurs, la question essentielle n’est pas seulement la bande passante maximale de la liaison, mais aussi le comportement de l’architecture dans les conditions exactes d’utilisation de l’application : opérations collectives, modèles parallèles et topologie.
Au niveau de la mémoire système, Compute Express Link (CXL) évolue également. Le consortium CXL annonce que la version 4.0 double la vitesse de signalisation, passant de 64 GT/s à 128 GT/s, ajoute des ports intégrés et améliore la fiabilité de la mémoire. CXL est particulièrement pertinent lorsque les architectes souhaitent une extension, une mise en commun ou une désagrégation cohérente de la mémoire sans pour autant considérer chaque niveau de mémoire comme un périphérique de stockage distant.
5. La photonique sur silicium se rapproche du silicium de commutation.
Le cuivre reste excellent pour les connexions électriques courtes et denses, mais les liaisons optiques deviennent de plus en plus intéressantes à mesure que la distance et la bande passante globale augmentent. Une étape majeure consiste à intégrer les composants optiques au sein même du réseau, au lieu de les loger entièrement dans des émetteurs-récepteurs enfichables en périphérie d'un commutateur.
NVIDIA affirme que sa plateforme Spectrum-X Ethernet Photonics utilise des composants optiques intégrés et offre une efficacité énergétique réseau jusqu'à cinq fois supérieure aux émetteurs-récepteurs enfichables traditionnels. Il s'agit d'une comparaison entre fournisseurs, et non d'une garantie pour toutes les topologies de centres de données, mais elle illustre la tendance actuelle : la consommation énergétique du réseau devient un enjeu suffisamment important pour que l'intégration optique fasse désormais partie intégrante de la conception des systèmes semi-conducteurs. Voir la présentation de la photonique sur silicium de NVIDIA .
Quelles sont les implications pour les charges de travail réelles en IA et en supercalcul ?
Charge de travail
Caractéristiques des semi-conducteurs à privilégier
Pourquoi elles sont importantes
préentraînement de grands modèles
Capacité et bande passante HBM, liaisons à montée en charge rapide, intégration dense, refroidissement puissant
L'entraînement repose en grande partie sur le déplacement des tenseurs et la communication synchronisée entre de nombreux accélérateurs.
Inférence à long contexte et inférence agentive
Grands pools de mémoire HBM, calcul efficace à faible précision, bande passante d'interconnexion élevée, hiérarchisation de la mémoire
Le cache KV et les étapes de raisonnement répétées peuvent rendre la capacité de mémoire et le déplacement des données plus limitants que les FLOPS de pointe.
Les codes de simulation dépendent souvent d'une double précision et d'une bande passante soutenue plutôt que d'un simple débit de tenseurs à faible précision.
Inférence d'entreprise
Performances par watt, compatibilité logicielle, mémoire adaptée, options de déploiement PCIe
Le meilleur système est peut-être celui qui s'adapte aux serveurs et à l'alimentation électrique existants, plutôt que l'architecture de rack à très haute densité.
accélérateurs personnalisés
Stratégie des puces, écosystème d'emballage, soutien de l'UCIe, maturité des processus
La modularité peut raccourcir les cycles de réutilisation, mais la complexité de l'emballage et la qualification de la chaîne d'approvisionnement peuvent en annuler les avantages.
Un exemple concret : pourquoi un GPU plus rapide ne suffit pas
Prenons l'exemple d'une équipe gérant un modèle de langage complexe avec de longues fenêtres de contexte. Supposons que le profilage révèle que les GPU sont fréquemment en attente de transferts de mémoire et de communications inter-GPU. Passer à un accélérateur plus récent pourrait être utile, à condition que ce nouveau système offre également une capacité HBM suffisante, une bande passante mémoire plus rapide et une topologie réduisant les interruptions de communication. Investir dans un appareil aux performances théoriques supérieures pour les tenseurs, tout en conservant les mêmes limitations en termes de mémoire et de réseau, pourrait apporter une amélioration bien moindre que celle annoncée.
Le même principe s'applique au supercalcul traditionnel. Le système Frontier du Laboratoire national d'Oak Ridge combine des accélérateurs AMD MI250X avec de la mémoire HBM et une interconnexion système à haut débit. Le guide utilisateur de Frontier explique le fonctionnement conjoint du calcul, de la mémoire HBM, des liaisons CPU-GPU et du réseau Slingshot. Bien que cette génération de matériel soit antérieure aux plateformes d'IA les plus récentes de 2026, l'enseignement architectural reste d'actualité : la performance soutenue des applications dépend de la qualité du cheminement entre le calcul, la mémoire et les autres nœuds.
Quand la mise à niveau vers un matériel semi-conducteur de nouvelle génération vaut-elle le coup ?
Une mise à niveau est plus justifiée lorsqu'elle résout un problème de performance précis plutôt que de simplement remplacer une pièce plus ancienne. Avant d'opter pour une nouvelle génération d'accélérateur, vérifiez les points suivants :
Pression sur la mémoire : le modèle ou la simulation déborde-t-il sur la mémoire hôte, nécessite-t-il une sauvegarde agressive des points de contrôle ou impose-t-il un degré de partitionnement du modèle gênant ?
Pression sur la bande passante : les noyaux sont-ils limités par la mémoire lors du profilage, ou les accélérateurs passent-ils un temps considérable à attendre la réduction globale et d’autres opérations collectives ?
Alimentation et refroidissement : le rack, l’installation et le circuit de refroidissement peuvent-ils supporter la nouvelle densité de puissance ? Des performances accrues peuvent s’avérer inadaptées si les mises à niveau de l’infrastructure représentent la part la plus importante des coûts.
Préparation du logiciel : le compilateur, les bibliothèques, les noyaux, la pile d’orchestration et les outils de surveillance sont-ils suffisamment matures pour la nouvelle architecture ?
Exigences de précision : La charge de travail peut-elle utiliser en toute sécurité des formats de précision inférieure, ou nécessite-t-elle le format FP64 ou un autre format de précision supérieure ?
Utilisation : La charge de travail permettra-t-elle d’exploiter suffisamment le nouveau matériel pour justifier son coût ? Une capacité inutilisée ne devient pas rentable du simple fait que la puce est plus récente.
Les compromis deviennent plus concrets.
Les progrès réalisés dans le domaine des semi-conducteurs permettent d'atteindre des performances impressionnantes, mais leurs limites sont de plus en plus concrètes. Les boîtiers avancés sont plus volumineux et plus complexes à fabriquer. Les empilements HBM concentrent la chaleur à proximité des circuits logiques haute puissance. Les systèmes à l'échelle du rack peuvent nécessiter un refroidissement liquide, une distribution d'énergie dense et une architecture réseau spécialisée. L'intégration de l'optique permet de réduire la consommation d'énergie du réseau, mais soulève de nouvelles problématiques de fabrication et de maintenance. Les chiplets améliorent la modularité, mais complexifient la validation, le conditionnement et la gestion du rendement.
Il existe également un compromis logiciel. Les opérations arithmétiques à faible précision, telles que FP8, FP6 ou FP4, peuvent considérablement augmenter le débit de l'IA, mais le logiciel doit préserver la qualité du modèle. Les codes scientifiques ne peuvent pas toujours utiliser les mêmes raccourcis. Une fonctionnalité des semi-conducteurs n'est utile que si la pile applicative peut l'exploiter sans compromettre la précision ni la fiabilité.
Que regarder ensuite ?
Pour le reste de 2026 et jusqu'en 2027, les signaux les plus pertinents ne se limitent pas aux nouveaux noms de nœuds. Il convient d'observer si les procédés A16 de TSMC et de la famille 18A d'Intel s'intègrent dans les produits destinés au grand public ; la rapidité avec laquelle les mémoires HBM4 et HBM4E seront disponibles à grande échelle ; si UCIe 3.0 permet une interopérabilité significative entre les puces de différents fournisseurs ; où CXL 4.0 apparaît dans les systèmes de production ; et si l'optique co-intégrée s'avère économique et facile à entretenir à grande échelle.
Ces étapes clés permettront de déterminer si l'industrie des semi-conducteurs peut continuer à développer l'IA et le supercalcul sans que les problèmes de gestion de la mémoire, d'alimentation électrique, de mise en réseau et de refroidissement n'annulent les gains obtenus grâce à une logique plus dense.
En résumé
L'avenir de l'IA et du supercalcul repose moins sur un seul « nœud de nouvelle génération » que sur une ingénierie des semi-conducteurs coordonnée. Les transistors GAA et l'alimentation par l'arrière améliorent les fondations logiques. Les chiplets et les techniques d'encapsulation avancées permettent aux concepteurs d'assembler des systèmes plus vastes qu'une seule puce ne peut en gérer aisément. La mémoire HBM4 alimente les accélérateurs à très large bande passante. UCIe, CXL, NVLink, Infinity Fabric et les réseaux optiques permettent le transfert de données sur des domaines de plus en plus étendus.
Si vous choisissez du matériel, commencez par identifier le véritable goulot d'étranglement de votre charge de travail. Pour l'IA gourmande en mémoire, privilégiez la capacité et la bande passante de la mémoire HBM. Pour l'entraînement distribué, privilégiez l'extensibilité verticale et horizontale. Pour le calcul scientifique, vérifiez les performances FP64 et des bibliothèques. Pour un déploiement en entreprise, tenez compte de la consommation électrique, du refroidissement, du support logiciel et de l'effort d'intégration. Le semi-conducteur le plus rapide sur le papier n'est pas forcément le système le plus rapide ni le plus économique pour votre charge de travail.