Accueil
» Technologie
»
Quelles sont les causes des pannes généralisées des plateformes cloud ? Les schémas de défaillance à l’origine des interruptions majeures
Quelles sont les causes des pannes généralisées des plateformes cloud ? Les schémas de défaillance à l’origine des interruptions majeures
Les interruptions généralisées des plateformes cloud sont rarement dues à la simple panne d'un serveur isolé. Les incidents les plus perturbateurs commencent généralement par une défaillance technique (une mauvaise configuration, un défaut logiciel, un problème DNS, une panne réseau ou un incident d'infrastructure) et se propagent ensuite car de nombreux services dépendent des mêmes plans de contrôle, bases de données, systèmes d'identité, équilibreurs de charge ou ressources régionales.
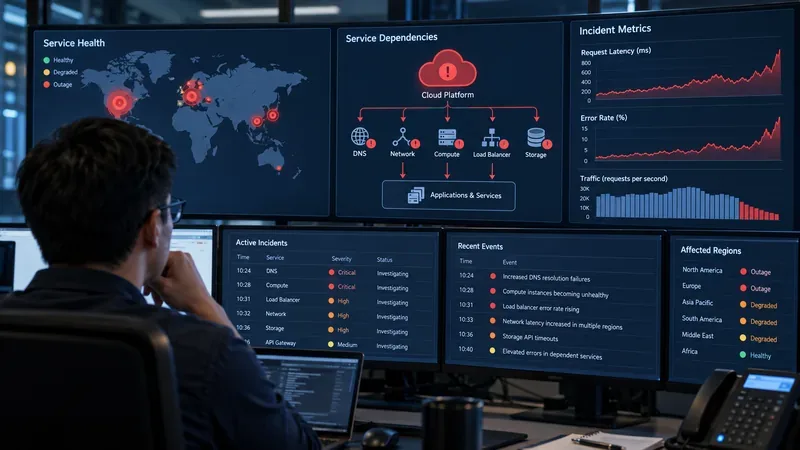
Scénario illustratif : prenons l’exemple d’un fournisseur de cloud fictif nommé Northstar Cloud. À 10h05, une modification automatisée du réseau est appliquée à un service régional. Quelques minutes plus tard, les clients signalent des échecs d’appels API. À 10h12, le lancement de nouvelles machines virtuelles est interrompu. À 10h20, les équilibreurs de charge commencent à signaler des serveurs backend fonctionnels comme indisponibles. À 10h35, des dizaines de produits, apparemment sans lien entre eux, sont dégradés. Ce scénario est hypothétique et ne décrit pas une panne réelle. Il est utile car il montre comment une petite défaillance initiale peut engendrer un incident majeur sur la plateforme.
Les équipes d'exploitation du cloud doivent souvent retracer une panne depuis la première dépendance défaillante jusqu'aux applications en aval, en passant par le DNS, le réseau, le calcul, l'équilibrage de charge et le stockage.
En résumé : les pannes majeures du cloud sont généralement des défaillances en cascade.
Les principales causes d'indisponibilité généralisée des plateformes cloud sont les erreurs de configuration et de déploiement, les défauts logiciels latents, les défaillances DNS et de routage, les dépendances de services partagés, la saturation des capacités lors d'une panne ou d'une reprise après incident, les problèmes de plan de contrôle et les défaillances physiques affectant un centre de données ou une zone de disponibilité. L'ampleur de la panne dépend moins de la cause de l'erreur initiale que du degré de partage du composant affecté.
Un exemple concret et pertinent nous vient d'AWS. Dans son rapport d'incident officiel relatif à la perturbation survenue en octobre 2025 en Virginie du Nord, AWS a indiqué qu'une condition de concurrence latente dans le système de gestion DNS automatisé de DynamoDB avait généré un enregistrement DNS vide et incorrect pour le point de terminaison régional. Cette défaillance DNS a affecté les clients et les services internes d'AWS dépendant de DynamoDB, et les opérations de récupération ultérieures ont engendré des problèmes au niveau des lancements d'EC2 et des équilibreurs de charge réseau. Cet incident est documenté dans le rapport d'incident d'AWS relatif à la perturbation de DynamoDB d'octobre 2025 .
1. Les modifications de configuration peuvent engendrer un rayon d'explosion anormalement important.
Les erreurs de configuration figurent parmi les causes les plus fréquentes d'incidents affectant les systèmes distribués de grande envergure, car les plateformes modernes sont gérées par l'automatisation. Une simple modification peut être déployée sur des milliers d'hôtes, de routeurs, d'enregistrements DNS ou de points de terminaison de service beaucoup plus rapidement qu'un opérateur humain ne pourrait le faire manuellement.
Reprenons l'exemple de Northstar Cloud. Supposons que la modification du réseau prévue à 10h05 ait été déployée sur dix machines, mais appliquée à plusieurs régions. Cette modification n'implique pas nécessairement la destruction de matériel. Elle peut simplement réduire la capacité réseau disponible, modifier le routage ou entraîner le rejet d'un trafic pourtant légitime. Lorsque la capacité partagée devient insuffisante, les clients subissent des délais d'attente et des tentatives de reconnexion, ce qui accroît encore la charge.
Google a décrit un mécanisme similaire dans son compte rendu officiel d'une interruption de service survenue en 2019 : une modification de configuration initialement prévue pour un petit nombre de serveurs dans une région a été appliquée par erreur à une échelle beaucoup plus large, empêchant plusieurs régions d'utiliser plus de la moitié de leur capacité réseau disponible. Le trafic a alors saturé la capacité restante. Voir la mise à jour officielle de Google concernant l'interruption de service de 2019 .
C’est pourquoi les opérateurs cloud expérimentés utilisent des déploiements progressifs, la validation, la restauration automatique, la limitation du taux de modification et des contrôles de l’impact des changements. Ces mesures de protection n’éliminent pas les incidents, mais elles peuvent empêcher qu’une modification malencontreuse ne se propage à l’ensemble de la plateforme.
2. Les défauts logiciels peuvent rester cachés jusqu'à ce que des conditions de synchronisation rares se produisent.
Les grandes plateformes cloud exécutent d'immenses parcs de logiciels distribués. Certains défauts restent latents pendant des mois, voire des années, car ils nécessitent une séquence d'événements rare : deux contrôleurs mettant à jour le même état, un délai inhabituel, des métadonnées obsolètes ou un processus de récupération s'exécutant simultanément à un processus de nettoyage.
Dans l'incident fictif de Northstar, imaginons que deux processus d'automatisation indépendants mettent à jour le même plan DNS. L'un est retardé, l'autre effectue une mise à jour plus récente, puis une routine de nettoyage supprime les données que le processus retardé vient d'activer. Chaque composant pris individuellement peut sembler fonctionner comme prévu, mais leur interaction crée un état invalide.
L'événement AWS DynamoDB de 2025 illustre parfaitement ce cas de figure. AWS a imputé la défaillance initiale à une condition de concurrence latente entre des composants de gestion DNS redondants. L'enjeu dépasse le cadre d'un seul fournisseur : la redondance n'améliore la fiabilité que si les composants redondants ne peuvent pas corrompre l'état partagé par le biais d'une même logique ou d'une défaillance de synchronisation.
3. Les pannes DNS et réseau peuvent rendre inaccessibles des systèmes en bon état de fonctionnement.
Un service peut être pleinement opérationnel et pourtant indisponible si les clients ne peuvent pas résoudre son nom d'hôte ou si les paquets ne peuvent pas l'atteindre. Le DNS, le routage, l'équilibrage de charge et la configuration réseau constituent donc des éléments critiques pour la quasi-totalité des produits cloud.
Dans notre exemple Northstar, les clients pourraient supposer que le service de calcul lui-même est défaillant en raison d'un délai d'attente dépassé lors des appels API. Or, les serveurs de calcul eux-mêmes pourraient être opérationnels, même si le DNS ne renvoie aucun point de terminaison utilisable, qu'une route est manquante ou qu'un équilibreur de charge a supprimé des cibles opérationnelles.
AWS a documenté ce type de défaillance à plusieurs reprises. Lors d'un incident survenu en 2018 dans la région de Séoul, AWS a indiqué qu'une mise à jour de configuration avait supprimé par erreur un paramètre spécifiant le nombre minimal d'hôtes opérationnels pour la flotte de résolveurs DNS EC2. La capacité réduite des résolveurs a alors entraîné l'échec des requêtes DNS provenant des instances EC2. Vous trouverez plus de détails dans le résumé AWS concernant le problème de résolution DNS EC2 survenu à Séoul en 2018 .
Les pannes de réseau s'amplifient rapidement car les applications tentent de reconnecter les appareils qui ont échoué. Ce comportement agressif de relance peut transformer une perturbation partielle du réseau en une augmentation considérable du trafic.
4. Les dépendances partagées peuvent entraîner la défaillance simultanée de services non liés.
Les services cloud ne sont pas des produits isolés. Une base de données gérée peut dépendre de services d'identité, d'un DNS interne, du stockage, du réseau, de systèmes d'ordonnancement, de services de certificats et de la télémétrie. Une plateforme sans serveur peut dépendre de la capacité de calcul, du réseau, de la mise en file d'attente et des bases de données du plan de contrôle. Si une dépendance partagée tombe en panne, de nombreux produits peuvent être affectés simultanément.
Cela explique l'un des symptômes de panne les plus déroutants : les clients constatent des erreurs dans plusieurs services et supposent qu'il s'agit de plusieurs défaillances indépendantes. En réalité, ces défaillances visibles peuvent toutes avoir une même cause en amont.
Dans le scénario Northstar, les services de machines virtuelles, de conteneurs et sans serveur pourraient tous tomber en panne car ils dépendent de la même base de données de ressources interne. Les produits destinés aux clients sont différents ; leur dépendance sous-jacente, elle, ne l’est pas.
L'incident AWS d'octobre 2025 a montré ce type de réaction en chaîne lorsque des services internes qui dépendaient de DynamoDB ont été affectés par le problème DNS initial, suivis d'effets de récupération en aval sur EC2, Network Load Balancer, Lambda, les services de conteneurs, les fonctions liées à l'identité et d'autres produits.
5. La reprise peut échouer car le retard accumulé est supérieur à la charge de fonctionnement normale.
Le rétablissement du composant défectueux d'origine ne met pas toujours fin à une panne. Pendant l'indisponibilité du service, les files d'attente s'allongent, les baux expirent, les contrôles d'intégrité échouent, les systèmes de mise à l'échelle automatique demandent une capacité de remplacement, les clients relancent leurs requêtes et les mises à jour de configuration s'accumulent. Lorsque la dépendance défaillante est rétablie, tous les systèmes en attente peuvent tenter de redémarrer simultanément.
Dans l'exemple de Northstar, supposons que le DNS soit réparé à 10h45. Des milliers de serveurs de calcul tentent alors de renouveler leurs baux expirés. Simultanément, les clients relancent les déploiements ayant échoué et les systèmes de mise à l'échelle automatique demandent des instances de remplacement. Le plan de contrôle se retrouve soudainement submergé par une charge de travail plusieurs fois supérieure à la normale. En l'absence de limitation de débit efficace ou de priorisation de la récupération, il peut entrer dans un second mode de défaillance, même si le bogue initial a disparu.
AWS a décrit un problème de récupération similaire en 2025 : après le rétablissement de l’accès à DynamoDB, un sous-système EC2 a dû rétablir un grand nombre de baux. Le traitement de l’arriéré est devenu difficile avant l’expiration des délais, et AWS a indiqué que le sous-système était entré dans un état de « surcharge ». Ce détail est important car il explique pourquoi la durée d’une panne peut être bien plus longue que le temps nécessaire pour corriger le problème initial.
6. Les contrôles de santé et le basculement automatique peuvent parfois réduire la capacité disponible.
Les contrôles d'intégrité sont essentiels, mais ils constituent également des systèmes de décision automatisés. Si un réseau est lent ou si la propagation des informations est retardée, un système de contrôle d'intégrité peut conclure que des ressources initialement saines sont défectueuses et les mettre hors service. Cela peut réduire davantage la capacité, créant ainsi un cercle vicieux.
Dans ce scénario fictif, les équilibreurs de charge de Northstar commencent à vérifier les instances nouvellement lancées avant que la configuration réseau ne soit entièrement propagée. Les vérifications échouent, les instances saines sont retirées, le trafic se reporte sur un nombre réduit de nœuds restants, qui finissent par être surchargés.
Ce problème est également apparu lors de l'événement AWS 2025. AWS a indiqué que les contrôles d'intégrité du Network Load Balancer échouaient parfois pendant la propagation de l'état du réseau pour les nouvelles instances, ce qui entraînait la mise hors service de certaines capacités. Cela nous rappelle que la logique de basculement doit être limitée en débit et testée en cas de défaillance partielle, et non uniquement dans des conditions « saines/défaillantes » classiques.
7. Des pannes de centres de données, d'alimentation électrique, de refroidissement et de zones de disponibilité restent possibles.
Les pannes ne sont pas toujours d'origine logicielle. L'alimentation électrique, le refroidissement, la fibre optique, le matériel réseau et d'autres infrastructures physiques peuvent tomber en panne. L'architecture cloud est conçue pour tenir compte de cette réalité, c'est pourquoi les principaux fournisseurs divisent les régions en zones isolées en cas de panne.
Microsoft explique que les zones de disponibilité Azure sont des groupes de centres de données distincts, dotés d'une alimentation électrique, d'un système de refroidissement et d'un réseau indépendants. Microsoft précise également qu'un déploiement zonal ne survit pas automatiquement à une panne de zone ; les clients doivent utiliser plusieurs zones ou des services redondants entre zones lorsque cela est possible. Consultez la présentation officielle des zones de disponibilité Azure de Microsoft .
Concrètement, un fournisseur de cloud peut rendre une zone indépendante, mais la charge de travail d'un client peut toujours avoir une base de données mono-zone, une dépendance de contrôle régionale unique ou un processus de basculement qui n'a jamais été mis en œuvre.
Pourquoi une panne de cloud peut sembler globale même si sa cause première est régionale
L'expression « panne mondiale » décrit souvent l'impact sur les clients, et non l'emplacement physique de l'équipement défaillant. Un service régional peut prendre en charge l'authentification, le DNS, les métadonnées, les pipelines de compilation, les tableaux de bord ou les API de contrôle utilisés depuis d'autres régions. Par conséquent, des applications réparties dans le monde entier peuvent tomber en panne car elles dépendent d'un service centralisé.
Cette distinction est cruciale pour diagnostiquer un incident. Les ingénieurs doivent se poser deux questions distinctes : où la première défaillance s’est-elle produite ? et quelles dépendances ont permis sa propagation ? Les réponses à ces questions sont souvent différentes.
Comment identifier la cause probable lors d'un incident en direct
Pour les opérateurs, la méthode la plus rapide consiste généralement à corréler les symptômes plutôt que d'examiner chaque produit séparément. Si plusieurs services tombent en panne simultanément, recherchez une dépendance commune. Si les charges de travail existantes restent opérationnelles tandis que les nouveaux déploiements échouent, suspectez un problème de plan de contrôle, de planification, de capacité ou de provisionnement. Si la connectivité IP fonctionne mais que les noms de service échouent, examinez le DNS. Si le taux d'erreur augmente après une annonce de rétablissement, recherchez des tempêtes de tentatives de connexion, des engorgements, des baux expirés, des boucles de rétroaction de contrôle d'intégrité ou une capacité de rétablissement insuffisante.
Les systèmes d'état des fournisseurs permettent également de distinguer un incident de plateforme d'une panne spécifique à une application. Google Cloud, par exemple, publie les incidents actuels et passés via son tableau de bord Service Health , tandis qu'AWS publie des résumés des événements majeurs via ses résumés post-événement .
Que peuvent faire les clients pour réduire l'impact
Aucune architecture ne peut garantir une disponibilité continue, mais certains choix de conception permettent de réduire les risques. Utilisez plusieurs zones de disponibilité pour les charges de travail de production lorsque le service le permet. Pour les charges de travail ne tolérant aucune interruption régionale, évaluez les architectures multirégionales et comprenez les compromis en matière de cohérence des données. Supprimez les points de défaillance uniques et cachés, tels qu'un service d'identité régional, un chemin DNS ou une API d'administration dont dépend toute action de récupération.
Les applications doivent également gérer les pannes avec élégance. Cela peut impliquer la mise en cache du contenu, la mise en file d'attente des écritures non critiques, la limitation des tentatives de reconnexion avec un délai exponentiel et une gigue, la séparation des opérations du plan de contrôle et du trafic du plan de données, et le maintien d'un mode réduit « lecture seule » ou « transaction principale » lors de pannes partielles. Les procédures de reprise doivent être testées en situation de forte charge, car le redémarrage d'une dépendance dans un environnement de test vide est très différent de sa restauration lorsque des millions de requêtes sont en attente.
La principale leçon tirée des pannes généralisées du cloud
Revenons au scénario de Northstar Cloud. La modification de configuration de 10h05 pourrait être l'élément déclencheur, mais n'explique pas tout. La panne se généralise car le réseau est partagé, l'automatisation présente un défaut de synchronisation, les services en aval dépendent du même état, les contrôles d'intégrité réduisent la capacité, les nouvelles tentatives augmentent la charge et les systèmes de récupération doivent traiter un important volume de requêtes en attente.
C’est le schéma central de nombreux incidents majeurs dans le cloud : la défaillance initiale est souvent mineure comparée à la chaîne de dépendances qui l’amplifie. Comprendre les interruptions de service du cloud implique donc d’examiner à la fois la cause première et la propagation. Les architectures les plus résilientes partent du principe que des composants individuels peuvent tomber en panne et s’attachent à empêcher que ces pannes ne dégénèrent en incidents affectant l’ensemble du système.