Accueil
» Technologie
»
Inside the Global Race for Advanced Chip Packaging and Fabrication
Inside the Global Race for Advanced Chip Packaging and Fabrication
A practical problem is becoming harder to ignore across the semiconductor industry: building a leading-edge chip is no longer just about printing smaller transistors. A cutting-edge AI accelerator can still miss its performance, cost, or delivery targets if high-bandwidth memory cannot be placed close enough to the logic, if an interposer is too large or expensive, if package yield is poor, or if advanced assembly capacity is located far from the wafer fab.
That is why the global semiconductor race in 2026 is increasingly a race across two connected fronts. The first is fabrication: gate-all-around transistors, backside power delivery, EUV lithography, yield, and capacity at roughly the 2nm class and beyond. The second is advanced packaging: chiplets, 2.5D interposers, 3D stacking, hybrid bonding, high-bandwidth memory integration, substrates, testing, and thermal management.
The distinction matters because a country or company can be strong in one layer and still depend heavily on another region for the rest of the system. For customers buying AI infrastructure, for governments funding semiconductor programs, and for companies planning supply chains, the key question is no longer simply “Who has the smallest node?” It is “Who can manufacture, integrate, test, and scale the entire system?”
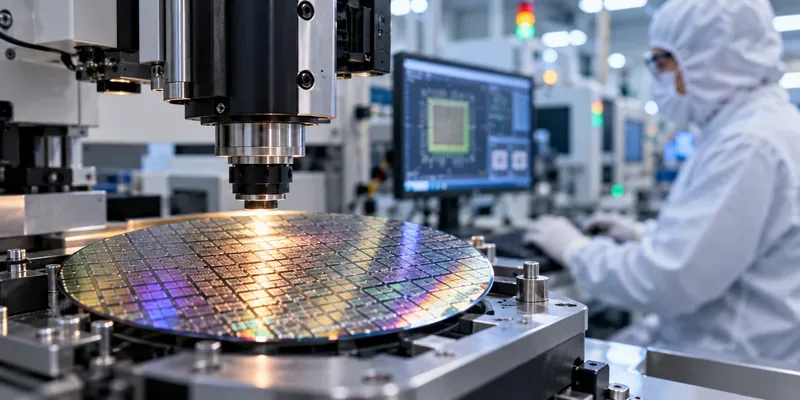
A semiconductor wafer under precision inspection equipment illustrates the front-end manufacturing side of a race that increasingly depends on advanced packaging and system integration as well.
Why packaging has become a first-order performance constraint
For decades, semiconductor progress was commonly summarized by transistor scaling. That remains important, but modern AI and high-performance computing systems are pushing against other physical limits at the same time.
One limit is die size. Lithography tools expose a finite field, so designers cannot simply make a monolithic processor arbitrarily large. Chiplets offer another path: divide a system into smaller dies and connect them with very high-bandwidth links inside one package. A second limit is memory bandwidth. AI accelerators need enormous data movement between logic and high-bandwidth memory (HBM), so distance, routing density, power delivery, and package geometry matter directly to system performance.
A third limit is economics. Very large leading-edge dies can be expensive because a defect can ruin a large amount of valuable silicon. Chiplet architectures can let designers put only the functions that truly need an advanced process on the most expensive node while using older or specialized nodes for I/O, analog, cache, or other functions. The trade-off is that packaging becomes much more difficult.
That is why terms such as CoWoS, SoIC, EMIB, Foveros, I-Cube, X-Cube, hybrid bonding, redistribution layers, and silicon bridges now appear in discussions that once focused almost entirely on process nodes.
The fabrication race: 2nm-class production is becoming real
TSMC: scaling N2 while pushing backside power and larger systems
TSMC states that its N2 process entered high-volume manufacturing in the fourth quarter of 2025 with good yield, and that N2P and A16 were scheduled for volume production in the second half of 2026. A16 adds TSMC’s Super Power Rail backside power technology for designs with demanding power-delivery and routing requirements. See TSMC’s 2025 annual report and its A16 technology overview.
The important point is not the marketing label attached to a node. Node names are not literal transistor dimensions and are not directly comparable across foundries. What matters is whether a process reaches acceptable yield, performance, power, density, design-tool maturity, and production volume for real customer products.
Intel: 18A combines gate-all-around with backside power
Intel says Intel 18A entered production in 2025 and is now in high-volume production in the United States. The process combines RibbonFET gate-all-around transistors with PowerVia backside power delivery. Intel also reported in June 2026 that the enhanced 18A-P variant had entered risk production. The company’s current material on Intel 18A distinguishes production status from future variants and provides the process claims with supporting technical references.
Intel’s strategy is particularly notable because it pairs front-end manufacturing with a large domestic advanced-packaging footprint. That matters for customers that want process technology, assembly, testing, and supply-chain geography to be planned as one system rather than as separate purchases.
Samsung: 2nm expansion tied to memory and packaging
Samsung’s foundry roadmap uses gate-all-around technology and increasingly ties its logic offerings to the company’s memory and advanced-package businesses. In its second-quarter 2026 results, Samsung said it planned to ramp production of new mobile products on its second-generation 2nm process during the second half of 2026 and reported expanding 2nm HPC engagements. Separately, Samsung and Broadcom announced a 2026 collaboration spanning 2nm-and-below foundry technology, HBM, and advanced packaging. See Samsung’s Q2 2026 results and the Samsung-Broadcom announcement.
The strategic advantage Samsung is trying to create is obvious: logic, memory, and packaging can be co-optimized. The challenge is equally clear—customers still judge a foundry by production yield, schedule reliability, ecosystem readiness, and the competitiveness of the final packaged system, not by a roadmap slide alone.
Japan’s Rapidus: a bid to re-enter leading-edge logic
Rapidus is attempting something different: rebuilding a leading-edge logic manufacturing base in Japan around a 2nm gate-all-around process. Its IIM-1 pilot line in Chitose began operating in April 2025, and Rapidus says mass production is targeted for 2027. In April 2026, Japan’s NEDO approved Rapidus’ fiscal-year plan covering both 2nm front-end development and chiplet/package design and manufacturing. Rapidus also reported a 600mm-square organic RDL interposer prototype and plans to verify 2.xD and 3D package processes at its Rapidus Chiplet Solutions facility. See Rapidus’ FY2026 project update.
This remains a forward-looking manufacturing program rather than proof of 2027 mass-production success. That distinction is important: prototype transistors, a working pilot line, a usable PDK, customer tape-outs, production yield, and sustainable high-volume manufacturing are separate milestones.
The packaging race: the package is becoming part of the computer architecture
TSMC is scaling CoWoS far beyond a conventional package
TSMC’s CoWoS family is central to many AI and HPC designs because it brings logic and HBM together on very large interposer-based systems. At its 2026 North America Technology Symposium, TSMC said it was producing 5.5-reticle-size CoWoS and planned a 14-reticle-size version for 2028 that could integrate roughly 10 large compute dies and 20 HBM stacks. The same roadmap includes SoIC 3D stacking and co-packaged optics. See TSMC’s 2026 technology symposium announcement.
The significance is architectural. As package area expands, designers can scale compute and memory without forcing every function onto one monolithic die. But larger packages make warpage, thermal gradients, substrate quality, interconnect integrity, power delivery, test strategy, and assembly yield harder to control.
Intel is betting on bridges plus vertical stacking
Intel’s packaging portfolio approaches the same problem with a different set of building blocks. EMIB embeds small silicon bridges in the substrate to connect dies laterally, while Foveros technologies support vertical stacking. Intel said in July 2026 that its New Mexico facilities were scaling packages beyond eight times the conventional reticle area, with plans to go beyond 12 times by 2028. Its latest EMIB-T adds through-silicon vias to improve power delivery and routing for demanding HBM-based systems. See Intel’s 2026 advanced-packaging overview.
This illustrates why packaging technologies should not be compared by a single metric. A full silicon interposer, an embedded silicon bridge, an RDL interposer, and a hybrid-bonded 3D stack make different trade-offs in bandwidth, cost, package area, thermal behavior, and manufacturing complexity.
Samsung is combining 2.5D, 3D, and memory integration
Samsung propose des solutions d'encapsulation 2.5D à interposeur silicium et à pont, ainsi que l'empilement 3D. Son matériel d'intégration hétérogène avancé actuel décrit la technologie 3D Cube-T utilisant des interconnexions TSV et une liaison par compression thermique, et la technologie 3D Cube-H en développement avec une liaison hybride cuivre sans bosses. Samsung continue également de positionner I-Cube et X-Cube dans le cadre de sa stratégie globale de fonderie et de mémoire. Consultez la présentation de l'intégration hétérogène avancée de Samsung .
La question qui reste en suspens n'est pas de savoir si ces techniques sont techniquement utiles, mais plutôt quelles combinaisons peuvent être fabriquées avec un rendement élevé, au format requis, avec l'approvisionnement nécessaire en HBM et à un coût acceptable pour les clients.
La géographie devient une spécification de fabrication
Cette course se joue aussi sur le lieu où se déroule chaque étape de production. La chaîne d'approvisionnement la plus résiliente n'est pas forcément celle qui compte le plus d'usines de fabrication ; c'est celle qui parvient à relier la fabrication des plaquettes, le conditionnement, les substrats, la mémoire, les tests, les équipements, les matériaux et les ingénieurs qualifiés, avec des délais et des risques maîtrisables.
Région
Direction vérifiée actuelle
Pourquoi c'est important
Taïwan
TSMC poursuit ses investissements majeurs dans les technologies N2 et d'emballage avancé et demeure le centre de son écosystème de fabrication de pointe le plus mature.
Les réseaux denses de fournisseurs, l'apprentissage cumulatif des processus et le couplage étroit entre la production en amont et l'emballage restent difficiles à reproduire rapidement.
États-Unis
Intel produit le 18A localement ; le plan de TSMC en Arizona s'est étendu à six usines de fabrication de circuits logiques, deux installations d'encapsulation avancée et un centre de R&D ; Amkor construit un grand campus d'encapsulation/test avancé en Arizona.
Les États-Unis tentent de combler l'écart entre la production nationale de plaquettes de pointe et l'assemblage avancé à grande échelle.
Corée du Sud
Samsung fait progresser la logique 2 nm, la mémoire HBM et l'intégration 2.5D/3D tandis que la Corée finance également des programmes d'infrastructure d'emballage avancés.
La colocalisation de la mémoire, de la logique et du conditionnement peut s'avérer stratégiquement précieuse pour les systèmes d'IA.
Japon
Rapidus développe une logique de 2 nm et un flux de R&D lié aux puces/à l'encapsulation avancée, visant une production de masse en 2027.
Le Japon tente de rétablir une logique de pointe nationale tout en tirant parti de ses atouts considérables en matière de matériaux et d'équipements.
Europe
Les lignes pilotes de la loi européenne sur les puces, telles que NanoIC et FAMES, élargissent l'accès à la R&D de procédés avancés et à l'expérimentation à l'échelle préindustrielle.
L'Europe renforce le développement technologique et le prototypage, même s'il ne faut pas confondre les capacités des lignes pilotes avec les grandes capacités de production commerciale de puces d'IA.
La page actuelle de TSMC en Arizona indique que son plan d'investissement aux États-Unis a atteint 265 milliards de dollars et comprend six usines de fabrication de circuits logiques, deux installations d'encapsulation avancée et un centre de R&D, la première usine d'encapsulation avancée entrant dans ses premières phases de construction début 2026. Voir le résumé actuel du projet de TSMC en Arizona .
L'emballage avancé devient également une priorité à part entière de la politique industrielle américaine. Amkor a lancé en 2025 la construction d'un campus d'emballage et de test en Arizona, dont l'investissement initial a été revu à la hausse pour atteindre 7 milliards de dollars, la production devant démarrer en 2028. En juin 2026, TSMC et Amkor ont annoncé un accord de collaboration de 10 ans en Arizona dans le domaine de l'emballage avancé et des tests. Voir l'annonce du partenariat TSMC-Amkor .
Au niveau de la R&D, le département du Commerce américain a annoncé en juillet 2026 des lettres d'intention totalisant 874 millions de dollars pour la recherche sur la chaîne d'approvisionnement informatique, incluant l'encapsulation avancée, les substrats, les matériaux, la photonique, les architectures et la mémoire. Voir l' annonce du NIST .
L'Europe emprunte une voie différente. L'UE a inauguré la ligne pilote NanoIC chez imec en février 2026, un programme de 2,5 milliards d'euros, dont 700 millions de fonds européens, axé sur les technologies de semi-conducteurs de nouvelle génération au-delà de 2 nm, à une échelle de R&D quasi industrielle. FAMES, au CEA-Leti, inauguré en janvier 2026, se concentre sur les technologies à très faible consommation. Ces infrastructures renforcent l'accès à la recherche et le développement des procédés, mais ne sauraient se substituer à l'annonce d'une nouvelle fonderie à grande échelle. Voir l'annonce de la Commission européenne concernant NanoIC .
La Chine s'attache également à développer ses capacités nationales de fabrication et d'encapsulation de semi-conducteurs. En 2026, sa politique nationale a maintenu les incitations fiscales pour les entreprises de production de semi-conducteurs et de tests/encapsulation avancés éligibles, tandis qu'une norme nationale d'interconnexion de puces 2.5D est entrée en vigueur le 1er mars 2026. Ces mesures témoignent du développement continu de l'écosystème, mais ne déterminent pas à elles seules le niveau de production ni la compétitivité d'un procédé de pointe particulier. Voir l' avis de politique fiscale de la NDRC de 2026 et la norme nationale d'interface de puces 2.5D .
Les principaux goulots d'étranglement se situent au niveau des interfaces.
La prochaine étape de la compétition se jouera moins sur les spécifications des composants isolés et davantage sur les interfaces entre les composants et les étapes de fabrication.
Bande passante logique-mémoire : L’ajout de piles HBM n’est utile que si le routage, l’intégrité du signal, la surface du boîtier et l’alimentation électrique évoluent en conséquence.
Gestion thermique : L’empilement des puces raccourcit les trajets électriques, mais peut compliquer la dissipation de la chaleur. Le refroidissement devient alors un problème de conception du boîtier, et non plus seulement un problème lié au rack serveur.
Tests sur puces fonctionnelles : Un boîtier complexe peut contenir de nombreuses puces coûteuses. Les tests avant assemblage sont essentiels car un seul composant défectueux peut compromettre la valeur de l’ensemble du boîtier.
Substrats et interposeurs : La plaquette logique la plus avancée est inutile si un boîtier ne peut pas être construit aux dimensions, à la densité de routage, à la planéité et au volume requis.
Liaison hybride : La liaison directe cuivre-cuivre peut augmenter la densité d’interconnexion et réduire la longueur de connexion, mais la propreté de fabrication, l’alignement, le rendement et les contraintes thermiques deviennent plus difficiles.
Optique intégrée : rapprocher les E/S optiques du calculateur peut réduire l'énergie et la latence du transfert de données, mais cela ajoute une discipline de fabrication supplémentaire à un ensemble déjà complexe.
C’est pourquoi la course aux semi-conducteurs récompense de plus en plus les entreprises capables de concevoir conjointement transistors, puces, interfaces mémoire, structures de boîtier, flux de test, alimentation et refroidissement. Le « back-end » n’est plus une simple étape de finition à faible valeur ajoutée. Pour les systèmes d’IA avancés, il fait partie intégrante de l’architecture.
Que regarder ensuite ?
L'erreur la plus fréquente est de considérer toutes les annonces de feuille de route comme équivalentes. Il est plus utile de hiérarchiser les preuves de la plus simple à la plus complexe : démonstrations technologiques en premier, puis production à risque, validations clients, qualification de la production, fabrication en grande série et enfin, rendements soutenus et rentabilité des expéditions.
En matière de fabrication, il faudra observer si la famille N2 de TSMC continue de monter en puissance, si Intel peut élargir l'adoption externe des procédés de la famille 18A, si Samsung transforme ses engagements en 2 nm en un volume durable et si Rapidus peut passer du succès de sa ligne pilote à une production à l'échelle commerciale en 2027.
En matière de packaging, il convient de surveiller la taille du boîtier, le nombre de puces HBM, le pas de liaison hybride, la stratégie de substrat, la méthodologie de test, les limites thermiques et la capacité réelle. L'expansion de la technologie CoWoS de TSMC, les systèmes EMIB/Foveros plus importants d'Intel, les travaux de Samsung sur la liaison hybride et les expériences RDL à l'échelle du panneau de Rapidus convergent tous vers la même conclusion : le boîtier lui-même devient plus grand, plus dense et plus intégré au système.
Sur le plan géographique, il convient d'observer si les nouveaux investissements américains, japonais, coréens et européens favorisent la création de pôles de fournisseurs autonomes plutôt que de sites phares isolés. Une usine sans accès à proximité aux services d'emballage, de matières premières, de pièces détachées, de tests, de main-d'œuvre qualifiée et d'assistance technique client peut néanmoins se heurter à des délais de production longs et à des dépendances cachées.
Comment vérifier si une allégation de course aux puces est pertinente ?
Avant d’accepter un titre annonçant une nouvelle technologie de puce « de pointe », faites un petit bilan :
L'affirmation concerne-t-elle un prototype, une production à risque ou une fabrication en grande série ?
La source indique-t-elle une date de production précise, ou seulement une date cible ?
Est-ce que l'étiquette du nœud est comparée comme si « 2 nm » signifiait la même chose chez tous les fondeurs ? Ce n'est pas le cas.
L'annonce concerne-t-elle uniquement la fabrication des plaquettes , ou également le conditionnement, l'intégration de la mémoire et les tests ?
Les dimensions du boîtier, l'intégration HBM, le rendement, la puissance délivrée et les aspects thermiques sont-ils abordés, ou seulement la densité des transistors ?
S’agit-il d’une usine de fabrication à volume commercial, d’une ligne pilote de R&D ou d’un site d’emballage/d’essais ?
Les chiffres d'investissement sont-ils déjà engagés, en cours d'élaboration ou encore conditionnés par des incitations et la demande future ?
Si une annonce passe ces contrôles, elle a plus de chances de représenter un changement significatif dans les capacités de production de semi-conducteurs plutôt qu'une étape importante d'une feuille de route présentée sans contexte de fabrication.
La course ne se gagne plus uniquement sur la plaquette de silicium.
La compétition mondiale dans le secteur des semi-conducteurs repose toujours sur la capacité à fabriquer les transistors les plus performants, mais cela ne suffit plus. L'intelligence artificielle a rendu la bande passante mémoire, la densité d'interconnexion, la taille des boîtiers, les tests, la gestion thermique et la répartition géographique de la chaîne d'approvisionnement indissociables des performances de calcul.
Taïwan demeure le centre névralgique de l'écosystème de fonderie et d'encapsulation de pointe le plus mature. Les États-Unis reconstruisent leurs capacités de production de semi-conducteurs et d'encapsulation à une échelle sans précédent. La Corée du Sud conjugue ses atouts en matière de mémoire, de logique et d'encapsulation. Le Japon s'efforce de renouer avec la logique de pointe tout en développant un écosystème de chiplets interconnectés. L'Europe étend ses infrastructures de R&D partagées, et la Chine continue de renforcer son soutien politique à la production nationale et à l'encapsulation.
La compétition la plus importante n'est donc pas simplement « 2 nm contre 2 nm ». Il s'agit de la course pour fournir un système complet et industrialisable : logique de pointe, mémoire, boîtier, alimentation, refroidissement, tests, rendement et volume – le tout simultanément.