Commencez par vérifier si les lenteurs de connexion affectent une seule salle, un seul serveur distant ou toutes les salles fédérées. Utilisez l'état et les journaux de la destination de fédération de Synapse pour identifier les échecs répétés avant de modifier les délais d'attente ou d'ajouter des nœuds de calcul. Une connexion implique le franchissement des limites des serveurs et l'échange de données d'autorisation et d'état des salles ; par conséquent, un serveur distant lent ou une grande salle peuvent retarder une connexion même si votre propre serveur fonctionne correctement.
La spécification serveur-serveur Matrix décrit la procédure make_joind' send_joinétablissement de liaison et l'état renvoyé au serveur qui rejoint la fédération. Par conséquent, un « délai de fédération » n'est pas systématiquement dû à un problème de file d'attente Synapse locale. Les vérifications ci-dessous permettent d'identifier les causes probables.
Le délai est-il limité à une seule pièce ou à un seul serveur domestique ?
Comparez une connexion lente avec une connexion à une autre salle fédérée. Demandez si d'autres utilisateurs de votre serveur principal signalent le même délai et notez l'identifiant ou l'alias de la salle ainsi que les noms des serveurs distants concernés. Si une seule salle est lente, le goulot d'étranglement peut provenir de son état ou des serveurs principaux qui s'y trouvent déjà. Si plusieurs salles utilisant le même serveur distant sont lentes, vérifiez l'accessibilité de cette destination et son état de tentatives de connexion. Si les connexions à de nombreux serveurs non liés sont lentes, examinez vos ressources et le chemin de fédération sortant.
Pour le serveur distant concerné, interrogez l'API d'administration de fédération de Synapse depuis la machine exécutant Synapse :
curl -H "Authorization: Bearer $SYNAPSE_ADMIN_TOKEN" \
  "http://127.0.0.1:8008/_synapse/admin/v1/federation/destinations/remote.example"
Remplacez remote.examplepar le nom de votre serveur d'accueil et utilisez l'adresse du client-écouteur pour votre déploiement. Une valeur différente de zéro retry_last_tset positive retry_intervalindique que Synapse a enregistré une tentative de connexion ayant échoué récemment et attend avant de réessayer. Consultez les journaux Synapse correspondants pour identifier la cause de l'échec, comme une erreur DNS, TLS, de connexion ou de réponse distante. Synapse indique que cette API d'administration de fédération est expérimentale et susceptible d'évoluer ; consultez la documentation de la version que vous utilisez. Conservez l'API d'administration privée et ne communiquez pas son jeton d'accès dans une demande d'assistance publique.
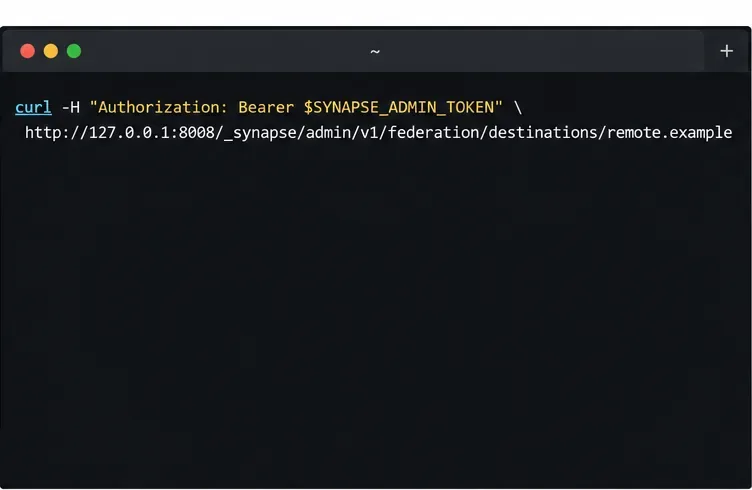
Illustration d'une requête locale authentifiée de statut de destination. Le panneau affiche uniquement une commande, et non une réponse en temps réel.
Si vous soupçonnez que d'autres serveurs ne peuvent pas accéder à votre serveur principal, exécutez l' outil de test de fédération Matrix officiel pour le nom de votre serveur. Il vérifie la découverte de la fédération publique et la connectivité. Il ne prouve pas à lui seul qu'une requête sortante de votre hôte Synapse vers un pair particulier aboutit ; comparez donc son rapport avec vos propres journaux et l'état de la destination.
Synapse affiche-t-il un délai de fédération croissant ?
Si Prometheus collecte déjà les données de votre point de terminaison de métriques Synapse, ajoutez les domaines concernés à federation_metrics_domainsla configuration homeserver.yaml, puis rechargez ou redémarrez Synapse conformément à votre processus de déploiement. Synapse peut exposer les métriques Prometheus relatives à l'âge des événements de salle persistants (PDU) envoyés et reçus des domaines que vous indiquez, comme décrit dans le manuel de configuration .
federation_metrics_domains:
  - matrix.org
  - remote.example
Utilisez la série temporelle obtenue pour déterminer si l'âge des événements entrants ou sortants augmente. Considérez-la comme une indication, et non comme une conclusion : la documentation de configuration de Synapse précise que le délai peut provenir du serveur d'origine ou du réseau. Un retard dans les séries temporelles sortantes vers plusieurs destinations indique un problème au niveau du chemin d'envoi ou de la capacité locale ; un retard isolé sur un seul pair nécessite de vérifier ce pair et la route qui y mène.
Illustration d'un concept de graphique d'âge de fédération ; les lignes ne représentent pas des mesures en temps réel provenant d'un serveur Synapse.

Illustration du paramètre Synapse utilisé pour activer les métriques d'âge des PDU pour les domaines distants sélectionnés.
Si de nombreuses opérations sont lentes, vérifiez l'utilisation du processeur, de la mémoire, la latence de la base de données et le tableau de bord de durée des transactions de Synapse. Le guide Grafana de Synapse indique que persist_eventsl'écriture d'événements dans la base de données peut entraîner une durée de transaction élevée ; il explique également que de nombreuses requêtes de suivi peuvent augmenter la charge de résolution d'état. Si ces mesures locales sont élevées simultanément aux jointures, identifiez et corrigez le goulot d'étranglement au niveau des ressources ou de la base de données avant d'ajuster les tentatives de fédération.
Un plus grand nombre de nœuds de traitement des expéditeurs de la fédération serait-il utile ?
N'augmentez la capacité d'envoi que lorsque la surveillance révèle une accumulation de tâches sortantes sur plusieurs destinations et que le processus actuel est saturé. La documentation actuelle de Synapse recommande d'utiliser synapse.app.generic_workercette federation_sender_instancesfonctionnalité plutôt que de créer de nouveaux déploiements autour de l'ancien type de worker d'envoi dédié.
Chaque destination sortante est attribuée à un expéditeur en fonction du hachage du nom du serveur distant. Plusieurs expéditeurs peuvent répartir le trafic sur de nombreux serveurs distants, mais les requêtes vers une destination lente restent associées à un seul expéditeur. L'ajout d'expéditeurs ne résoudra donc probablement pas un problème d'accès unique. Les noms des expéditeurs dans la configuration partagée doivent correspondre aux expéditeurs en cours d'exécution ; lors de la modification de la liste des instances d'expéditeur, arrêtez et redémarrez simultanément tous les expéditeurs de la fédération afin qu'ils utilisent la même configuration.
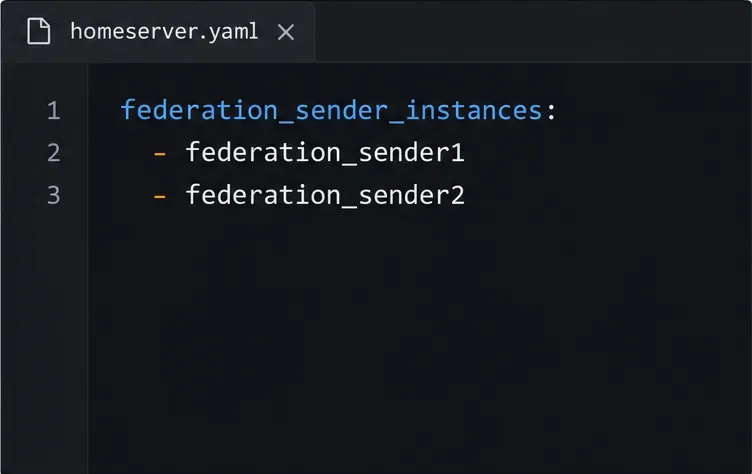
Illustration de la liste federation_sender_instances ; chaque worker nommé doit exister dans le déploiement.
Faut-il réinitialiser le délai de temporisation ou augmenter le délai d'expiration ?
Réinitialisez le délai de nouvelle tentative d'une destination uniquement après avoir résolu un problème de connectivité temporaire et confirmé que Synapse a bien indiqué que cette destination était défaillante. L'API d'administration fournit un POST /_synapse/admin/v1/federation/destinations/<destination>/reset_connectionpoint de terminaison ; sa requête s'exécute en arrière-plan, par conséquent, une réponse HTTP 200 immédiate ne signifie pas que la fédération est rétablie. Ce point de terminaison est également documenté comme expérimental.
Ne pas utiliser federation.client_timeoutcomme première réponse. Le manuel de configuration actuel prévoit un délai d'attente par défaut de 60 secondes. Un délai plus long donne plus de temps de réponse à un serveur distant lent ; cela n'améliore ni la vitesse du serveur ni celle du réseau et peut allonger les temps d'attente des requêtes d'adhésion. Ne modifiez ce délai que lorsque les journaux indiquent que le nombre de requêtes de fédération légitimes dépasse la valeur actuelle et que vous avez vérifié la capacité du serveur.
Comment savez-vous que la solution a fonctionné ?
Réessayez de rejoindre la même salle et comparez le résultat avec une autre salle fédérée. Vérifiez que la destination concernée n'affiche plus d'intervalle de nouvelle tentative croissant, que les journaux indiquent des requêtes de fédération réussies et que les métriques d'âge des PDU configurées cessent d'augmenter. Si une seule salle reste lente alors que les autres fonctionnent correctement, communiquez son ID, le serveur distant concerné, la plage horaire et les lignes d'erreur masquées aux administrateurs de la salle ou au support Synapse. Évitez d'envoyer les jetons d'accès ou les en-têtes d'autorisation complets.


