Accueil
» Aujourd'hui
»
Mistral Large 4 : nouveautés, performances et usages de la nouvelle IA
Mistral Large 4 : nouveautés, performances et usages de la nouvelle IA
Mistral Large 4 est bien réel : Mistral AI l’a annoncé le 6 octobre 2026 et l’a rendu disponible en Public Preview via son API. Mais plusieurs raccourcis circulent déjà autour de cette sortie. Le plus important est de distinguer ce qui est disponible aujourd’hui de ce qui est seulement annoncé. Le modèle peut être testé maintenant dans Mistral Studio et via l’API, tandis que les poids ouverts ne doivent arriver qu’à la fin du mois d’octobre. Autrement dit, « open-weight » décrit la destination du produit, pas encore son état de distribution au 7 octobre 2026.
Selon la présentation officielle de Mistral Large 4 et la fiche modèle officielle, ML4 est un modèle multimodal généraliste de type Mixture-of-Experts, ou MoE. Cela signifie qu’il contient un très grand nombre de paramètres, mais n’en active qu’une partie pour chaque requête. Mistral indique environ 1,05 billion de paramètres au total, 49 milliards de paramètres actifs et un encodeur visuel de 1,6 milliard de paramètres. Sa fenêtre de contexte atteint 1 million de tokens.
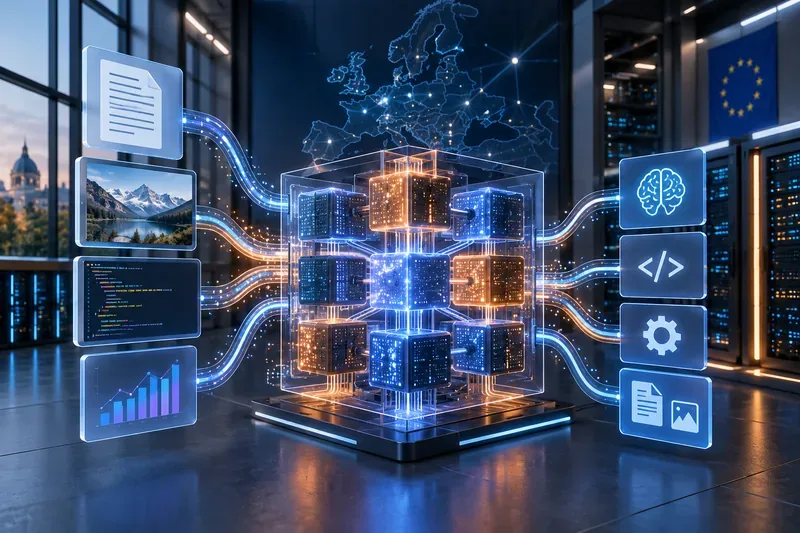
Une infrastructure d’IA européenne reliant documents, images, code et outils : une représentation des usages multimodaux et agentiques mis en avant pour Mistral Large 4.
Ce qui change vraiment avec Mistral Large 4
Le principal changement n’est pas simplement « un modèle plus gros ». Mistral cherche à réunir dans un seul modèle plusieurs capacités qui étaient souvent réparties entre des modèles spécialisés : instruction générale, raisonnement, code, utilisation d’outils, workflows agentiques et compréhension visuelle. Le modèle accepte donc des entrées multimodales et peut être employé dans des scénarios mêlant texte, images, documents et actions via API.
Le contexte de 1 million de tokens est également un saut important par rapport à Mistral Large 3, dont la fiche officielle indique 256 000 tokens. Cela peut faciliter l’analyse de longs dossiers, de grandes bases de code ou de nombreux documents dans une même requête. Toutefois, une grande fenêtre de contexte ne garantit pas automatiquement une meilleure réponse sur chaque tâche. Plus de contexte signifie aussi davantage de données à sélectionner, un coût potentiel plus élevé et la nécessité de vérifier si le modèle exploite réellement les éléments pertinents.
Action utile : si votre cas d’usage dépend de longs documents, testez ML4 avec un corpus représentatif et mesurez non seulement la longueur maximale acceptée, mais aussi le taux de récupération des informations importantes à différentes positions dans le contexte.
Idée reçue n°1 : « Mistral Large 4 est déjà téléchargeable et auto-hébergeable »
Ce n’est pas encore confirmé au moment de cette publication. Mistral qualifie ML4 d’open-weight et annonce la publication des poids d’ici la fin d’octobre 2026. Le journal des changements officiel précise lui aussi que les poids arrivent prochainement. Tant que ces fichiers, leurs formats et leurs conditions de licence ne sont pas effectivement publiés, il est prématuré de présenter l’auto-hébergement comme une option immédiatement disponible.
Cela compte particulièrement pour les équipes qui veulent du souverain, du privé ou de l’on-premise. Une architecture MoE de plus d’un billion de paramètres au total peut demander une infrastructure lourde même si seulement 49 milliards de paramètres sont actifs lors de l’inférence. Le coût réel dépendra des formats de poids, de la quantification, du moteur d’inférence, du parallélisme et des exigences de débit.
Action utile : pour un projet à lancer maintenant, évaluez l’API en Public Preview. Pour un projet on-premise, attendez la publication des poids et des détails d’architecture avant de dimensionner les GPU ou de promettre un coût d’exploitation.
Performances : que peut-on réellement conclure ?
Mistral publie des résultats solides, mais il faut les lire avec méthode. Dans son annonce, l’entreprise rapporte 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA et 28,3 % sur Terminal-Bench 4, avec un Coding Agent Index combiné de 49,8 %. Pour les workflows agentiques généraux, ML4 atteint 59,9 % sur AutomationBench selon les chiffres cités par Mistral. Sur la cybersécurité, l’entreprise indique notamment 93 % sur Cybench et 82 % sur une épreuve de reproduction puis correction d’une vulnérabilité réelle.
Ces scores sont utiles pour situer le modèle, mais ils ne prouvent pas que ML4 sera automatiquement meilleur sur votre codebase, vos tickets Jira, vos contrats ou vos fichiers Excel. Certains résultats proviennent de bancs tiers, d’autres d’évaluations pilotées ou présentées par Mistral. De plus, le modèle est encore en Public Preview et Mistral précise que son entraînement par renforcement se poursuit.
Action utile : utilisez les benchmarks pour sélectionner une courte liste de modèles, puis organisez un test interne en aveugle avec vos propres tâches, vos critères de précision, votre budget de latence et votre coût par résultat acceptable.
Idée reçue n°2 : « 1,05 billion de paramètres signifie 1,05 billion utilisés à chaque réponse »
Non. Mistral Large 4 repose sur une architecture Mixture-of-Experts. Le modèle compte environ 1,05 billion de paramètres au total, mais Mistral annonce 49 milliards de paramètres actifs. Dans un MoE, un mécanisme de routage sélectionne une partie des experts pour traiter chaque token ou portion de calcul. Cette conception vise à augmenter la capacité totale du modèle sans engager tous les paramètres pour chaque étape d’inférence.
Il ne faut toutefois pas en déduire que le modèle aura le coût matériel d’un modèle dense de 49 milliards de paramètres. Les poids complets doivent toujours être stockés ou distribués d’une manière compatible avec l’architecture, et la communication entre experts peut peser sur la mémoire, le réseau inter-GPU et la latence.
Action utile : lorsque les poids seront disponibles, dimensionnez l’infrastructure à partir des recommandations d’inférence réelles et de mesures de mémoire, pas uniquement à partir du chiffre « 49B actifs ».
Mistral Large 4 face à Mistral Large 3 : quel compromis ?
Le choix n’est donc pas simplement « nouveau contre ancien ». ML4 est pertinent si vous avez besoin du contexte long, de capacités agentiques plus avancées ou de la nouvelle pile multimodale. Large 3 peut rester préférable lorsque la disponibilité des poids, une intégration déjà validée ou une exploitation plus prévisible comptent davantage que le dernier niveau de performance.
Action utile : ne migrez pas uniquement à cause du numéro de version. Listez les capacités qui vous manquent aujourd’hui, puis vérifiez si ML4 les améliore suffisamment pour justifier un nouveau cycle d’évaluation et d’intégration.
Idée reçue n°3 : « Le modèle est forcément moins cher grâce au MoE »
Le MoE peut améliorer l’efficacité du calcul, mais le prix API reste un choix commercial distinct. La fiche officielle affiche un tarif standard de 1,36 dollar par million de tokens en entrée et 4,18 dollars par million de tokens en sortie. Au lancement, Mistral applique une remise de 50 % pendant deux semaines, soit 0,68 dollar en entrée et 2,09 dollars en sortie par million de tokens. Les entrées mises en cache sont également affichées à un tarif réduit pendant cette période.
Ce tarif de lancement peut rendre les premiers essais attractifs, mais il ne faut pas l’utiliser comme base permanente pour une projection budgétaire. Un agent qui effectue des recherches, appelle plusieurs outils et génère de longues sorties peut consommer bien plus de tokens qu’un simple chatbot.
Action utile : calculez le coût sur un workflow complet, y compris les appels intermédiaires, les reprises et les sorties, puis refaites le calcul avec le tarif hors promotion.
Quels usages semblent les plus crédibles aujourd’hui ?
Développement logiciel et agents de code
Les résultats publiés sur DeepSWE, SWE-Atlas-QnA et Terminal-Bench suggèrent que le code est l’un des axes forts de ML4. Les cas les plus intéressants sont probablement l’analyse de dépôts volumineux, les corrections multi-fichiers, les migrations et les agents capables d’utiliser un terminal ou des outils.
Action utile : mesurez le taux de tâches terminées sans intervention, mais aussi le nombre de régressions introduites et le temps humain nécessaire à la revue.
Analyse documentaire et travail de connaissance
Le contexte 1M et la multimodalité rendent ML4 pertinent pour des dossiers juridiques, financiers ou techniques contenant des PDF, tableaux, graphiques et texte. Mistral affirme de bonnes performances sur des évaluations financières et juridiques, mais ces domaines exigent une vérification humaine stricte.
Action utile : imposez des citations de sources, contrôlez les calculs et séparez les tâches de synthèse des décisions réglementées ou à fort impact.
Cybersécurité
Mistral met fortement en avant la cybersécurité, y compris l’analyse de vulnérabilités, le triage de malware et la génération de règles de détection. Le modèle est également présenté comme moins sujet aux refus qui peuvent bloquer des usages défensifs légitimes. Cela ne supprime pas la nécessité de garde-fous, d’autorisation et de journalisation.
Action utile : limitez les outils et privilèges de l’agent, exécutez les analyses dans un environnement isolé et exigez une validation humaine avant toute action sur un système réel.
Vision et ingénierie
Mistral insiste sur le visual grounding, c’est-à-dire la capacité à relier une réponse à une zone précise d’une image. L’entreprise cite des scénarios comme les plans techniques, les images satellites ou l’inspection de documents visuels complexes. C’est prometteur pour l’ingénierie et l’observation, mais un benchmark de vision ne remplace pas une validation métier.
Action utile : testez le modèle sur des images provenant réellement de votre pipeline, avec les mêmes résolutions, artefacts, annotations et seuils d’erreur que votre production.
Ce qui reste encore inconnu
Au 7 octobre 2026, plusieurs éléments importants ne sont pas encore finalisés publiquement. Les poids ne sont pas téléchargeables, les détails complets d’architecture doivent encore être publiés, et Mistral annonce d’autres benchmarks ainsi que davantage d’informations sur la méthodologie de post-entraînement. Le modèle lui-même est encore présenté comme un aperçu public en évolution.
Il faut donc éviter deux excès : considérer ML4 comme une simple annonce sans substance, alors qu’une API et de nombreux résultats sont déjà disponibles, ou au contraire le traiter comme une plateforme totalement stabilisée pour un déploiement critique.
Action utile : si votre projet tolère une phase d’expérimentation, commencez maintenant par l’API. Si vous avez besoin d’un SLA strict, d’un déploiement souverain auto-hébergé ou d’une certification interne lourde, attendez les poids, les détails de licence et une version plus stabilisée.
Faut-il tester Mistral Large 4 maintenant ?
Oui, si votre objectif est d’évaluer rapidement les nouvelles capacités de Mistral sur le code, les agents, la multimodalité ou les longs contextes. Le statut Public Preview implique cependant qu’il faut isoler cette expérimentation des dépendances critiques et conserver un modèle de repli.
Pour une équipe déjà satisfaite de Mistral Large 3 ou d’un autre modèle mature, il n’y a aucune urgence à migrer sans test comparatif. Les gains potentiels doivent être mesurés sur la qualité finale, la latence, le coût, la fiabilité des appels d’outils et le taux de corrections humaines nécessaires.
En résumé, Mistral Large 4 représente une évolution importante et vérifiable de la gamme Mistral : modèle MoE multimodal, contexte 1M, orientation forte vers le code, les agents, la cybersécurité et le travail professionnel. Ce qui n’est pas encore acquis, c’est la maturité opérationnelle d’une version stable et auto-hébergeable. La meilleure décision aujourd’hui consiste donc à tester les capacités qui vous intéressent, mesurer vos propres résultats, puis réévaluer lorsque les poids et les détails techniques complets seront publiés.